Explorarea instrucțiunilor SIMD în Rust

Scris de Denis Nuțiu
- 15 minute de citit
- 17 exemple de cod
- 2 imagini
Disponibil și în English
Pe această pagină
Salut 👋,
Am început să explorez Rust acum o săptămână, deoarece la locul de muncă tot mai multe servicii web sunt scrise în Rust, iar până acum îmi place limbajul: este simplu, rapid și frumos.
Activitățile mele zilnice de programare sunt în Python, Go și Java. Am folosit și C# pentru câteva proiecte personale. Învățarea Rust nu este chiar ușoară pentru mine, deoarece tot ce scriu sunt servicii web sau programe Java care nu conțin logică „de nivel jos”.
În acest articol voi vorbi despre drumul meu cu Rust și despre experiența mea cu std::simd. Mă fascinează lucrurile cu care nu am prea multă experiență. Am încercat și SIMD cu Go, dar este peste nivelul meu de pricepere, nu am reușit să-l fac să funcționeze.
Ce este SIMD?
SIMD înseamnă Single Instruction/Multiple Data (o instrucțiune, mai multe date). Să presupunem un vector de 128 de elemente.
[1,2,3, …, 128]
Când adunăm elementele, parcurgem fiecare element în buclă. Un cod tipic va arăta astfel:
int sum(int * arr, int size) { int sum = 0; for (int i = 0; i < size; i++) { sum = sum + *(arr + i); } return 0;}Assembly-ul generat va arăta cam așa:
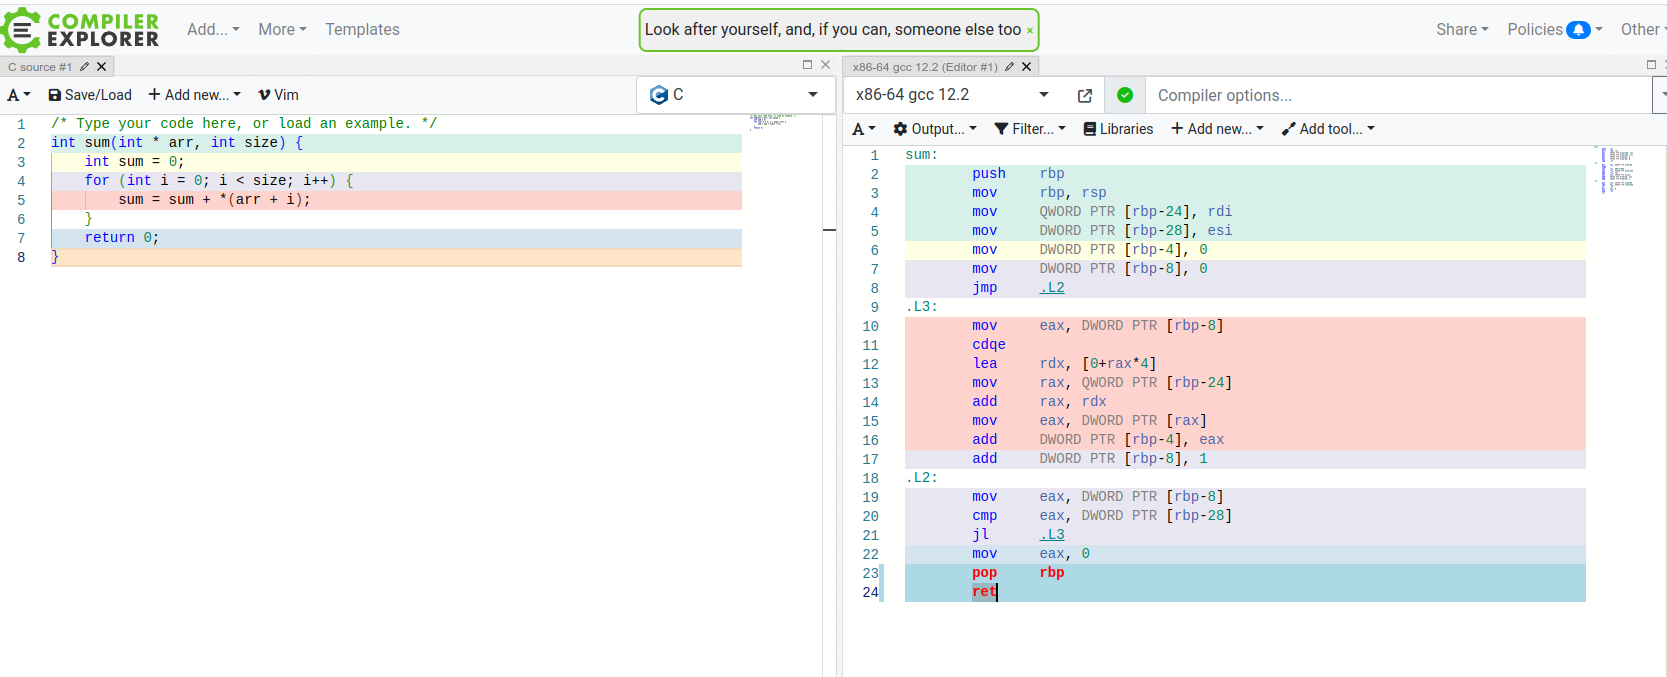 Codul cu ROȘU este partea de buclă, după cum vezi avem o mulțime de instrucțiuni. Uneori, când size este cunoscut, compilatorul poate alege să facă loop unrolling, adică în loc să folosească instrucțiuni JMP și să facă buclă, compilatorul va face ceva de genul acesta, de exemplu dacă size este 3:
int sum(int * arr, int size) { int sum = 0; sum = sum + *(arr + 0); sum = sum + *(arr + 1); sum = sum + *(arr + 2); return 0;}Cu instrucțiuni SIMD, procesorul tău are suport pentru instrucțiuni assembly care pot lucra cu vectori într-un mod eficient. Poți citi mai multe despre SIMD și despre cum funcționează în acest articol excelent Crunching Numbers with AVX and AVX2.
În esență, dacă ai doi vectori a și b, îi spui compilatorului să efectueze o operație matematică asupra lor, iar aceasta va fi eficientă. Imaginează-ți că, în loc să parcurgi fiecare element și să execuți operația +, toate elementele sunt adunate deodată:
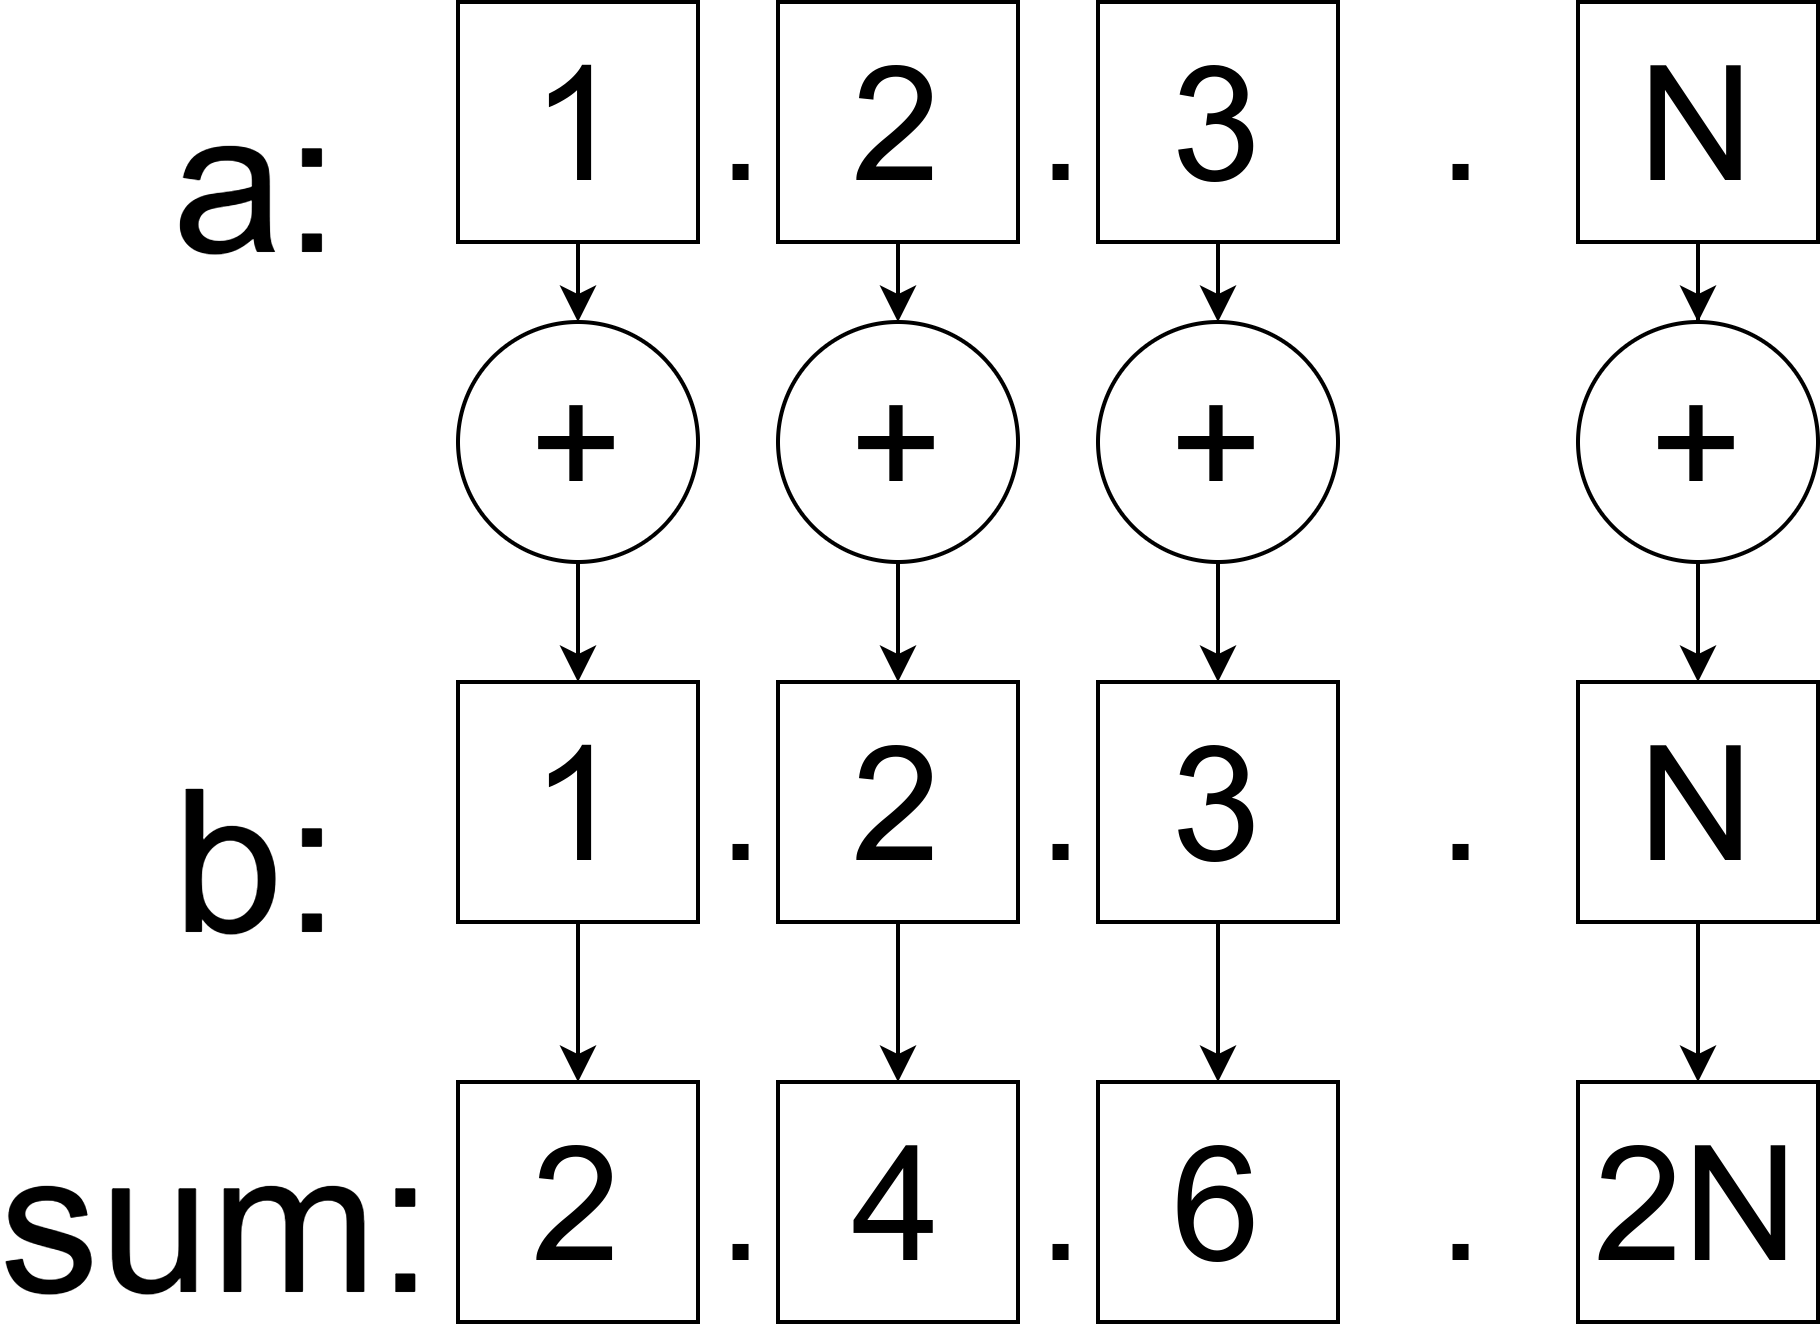 Acum că avem o înțelegere de bază a modului în care funcționează SIMD, putem trece la Rust.
Program Rust pentru calculul distanței Hamming
Notă:
dacă vrei să urmărești sau să rulezi codul din acest articol, va trebui să instalezi versiunea nightly de Rust și să o setezi ca implicită:
rustup install nightlyrustup default nightlycând ai terminat:rustup default stableProblema pe care vrem să o rezolvăm cu instrucțiuni SIMD este calculul distanței Hamming pentru doi vectori de aceeași dimensiune. Distanța Hamming dintre [1, 2, 3] și [1, 3, 3] este egală cu 1, deoarece 2 != 3, iar restul elementelor sunt egale.
Funcția Rust non-SIMD arată astfel:
#[inline(never)]fn hamming_distance_classic(a: &mut Vec<i32>, b: &mut Vec<i32>) -> u64 { let mut distance = 0; let length = a.len(); for i in 0..length { if a[i] != b[i] { distance += 1 } } return distance;}Pentru a previzualiza assembly-ul, un coleg mi-a recomandat crate-ul cargo-show-asm. Îl poți instala și rula următoarea comandă pentru a afișa codul assembly al funcției date
cargo asm --bin rust_simd "rust_simd::hamming_distance_classic"Assembly-ul generat arată ca o buclă simplă:
.LBB12_4: cmp r8, rcx jae .LBB12_5 mov r10d, dword ptr [rdi + 4*r9] xor r11d, r11d cmp r10d, dword ptr [rdx + 4*r9] lea r10, [r9 + 1] setne r11b add rax, r11 mov r9, r10 cmp rsi, r10 jne .LBB12_4 pop rcx .cfi_def_cfa_offset 8 retÎn continuare, îmi voi arăta implementarea care folosește instrucțiuni SIMD:
#[inline(never)]fn hamming_distance_simd(a: &mut Vec, b: &mut Vec) -> u32 { let mut distance: u32 = 0; let lanes = 16; let chunks = a.len() / lanes; for i in 0..chunks { // creează vectori SIMD let a: i32x16 = Simd::from_slice(&a[i*lanes..i*lanes+lanes]); let b: i32x16 = Simd::from_slice(&b[i*lanes..i*lanes+lanes]); // XOR SIMD let z = a.simd_ne(b); distance += z.to_bitmask().count_ones(); } return distance;}Codul assembly pentru această funcție arată astfel:
.LBB11_2: cmp r8, rsi ja .LBB11_6 cmp r8, rcx ja .LBB11_7 movdqu xmm1, xmmword ptr [rdi + 4*r8 - 64] movdqu xmm2, xmmword ptr [rdi + 4*r8 - 48] movdqu xmm3, xmmword ptr [rdi + 4*r8 - 32] movdqu xmm4, xmmword ptr [rdi + 4*r8 - 16] movdqu xmm5, xmmword ptr [rdx + 4*r8 - 64] pcmpeqd xmm5, xmm1 movdqu xmm1, xmmword ptr [rdx + 4*r8 - 48] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [rdx + 4*r8 - 32] pcmpeqd xmm2, xmm3 movdqu xmm3, xmmword ptr [rdx + 4*r8 - 16] pcmpeqd xmm3, xmm4 pxor xmm1, xmm0 pxor xmm5, xmm0 packssdw xmm5, xmm1 pxor xmm2, xmm0 pxor xmm3, xmm0 packssdw xmm2, xmm3 packsswb xmm5, xmm2 pmovmskb r10d, xmm5 mov r11d, r10d shr r11d and r11d, 21845 sub r10d, r11d mov r11d, r10d and r11d, 13107 shr r10d, 2 and r10d, 13107 add r10d, r11d mov r11d, r10d shr r11d, 4 add r11d, r10d and r11d, 3855 mov r10d, r11d shr r10d, 8 add r10d, r11d movzx r10d, r10b add eax, r10d add r8, 16 dec r9 jne .LBB11_2Vedem că registrele XMM sunt folosite.
Benchmarking-ul codului
Pentru a face benchmark codului, am folosit un bloc de cod pe care l-am copiat de pe o pagină despre SIMD în Rust[1] și pe care l-am modificat puțin.
mod bench { extern crate test; use self::test::Bencher; use std::iter; static BENCH_SIZE: usize = 128; macro_rules! bench { ($name:ident, $func:ident) => { #[bench] fn $name(b: &mut Bencher) { let mut x: Vec<_> = iter::repeat(1i32) .take(BENCH_SIZE) .collect(); let mut y: Vec<_> = iter::repeat(1i32) .take(BENCH_SIZE) .collect(); b.iter(|| { super::$func(&mut x, &mut y); }) } } } bench!(simd, hamming_distance_simd); bench!(vanilla, hamming_distance_classic);}Rezultatele sunt următoarele. Codul scris cu SIMD câștigă:
/home/denis/.cargo/bin/cargo bench --color=always --package rust_simd --bin rust_simd bench Finished bench [optimized] target(s) in 0.00s Running unittests src/main.rs (target/release/deps/rust_simd-2477d04109c1c861)running 2 teststest bench::simd ... bench: 14 ns/iter (+/- 0)test bench::vanilla ... bench: 20 ns/iter (+/- 0)Inlining-ul funcțiilor
Dacă eliminăm #[inline(never)], atunci se întâmplă ceva interesant. Compilatorul observă că ambele funcții sunt folosite o singură dată și decide să le facă inline.
Dacă rulăm cargo asm –bin rust_simd, funcțiile nu mai apar în rezultat:
Try one of those by name or a sequence number 0 "alloc::alloc::box_free" [15] 1 "alloc::raw_vec::RawVec::reserve_for_push" [136] 2 "alloc::raw_vec::finish_grow" [110] 3 "core::ops::function::FnOnce::call_once" [19] 4 "core::ptr::drop_in_place>" [31] 5 "core::ptr::drop_in_place" [27] 6 "core::ptr::drop_in_place::>" [7] 7 "main" [18] 8 "rand::rngs::adapter::reseeding::ReseedingCore::reseed_and_generate" [157] 9 "rust_simd::main" [787]10 "std::rt::lang_start" [28]11 "std::rt::lang_start::" [18]12 "std::sys_common::backtrace::__rust_begin_short_backtrace" [22]Rulând din nou benchmark-ul, obținem următorul rezultat:
/home/denis/.cargo/bin/cargo bench --color=always --package rust_simd --bin rust_simd bench Finished bench [optimized] target(s) in 0.00s Running unittests src/main.rs (target/release/deps/rust_simd-2477d04109c1c861)running 2 teststest bench::simd ... bench: 20 ns/iter (+/- 0)test bench::vanilla ... bench: 0 ns/iter (+/- 0)Funcția vanilla (distanța Hamming clasică) este mult mai rapidă, iar dacă ne uităm la codul assembly, vedem că și compilatorul Rust este inteligent și a vectorizat automat codul pentru a folosi instrucțiuni SIMD. Spre deosebire de mine, compilatorul este mai deștept și codul lui este mai bun:
.LBB11_56: movq xmm3, qword ptr [r15 + 4*rdx] movq xmm4, qword ptr [r15 + 4*rdx + 8] movq xmm5, qword ptr [rbp + 4*rdx] pcmpeqd xmm5, xmm3 movq xmm3, qword ptr [rbp + 4*rdx + 8] pcmpeqd xmm3, xmm4 pshufd xmm4, xmm5, 212 pandn xmm4, xmm2 paddq xmm4, xmm0 pshufd xmm3, xmm3, 212 pandn xmm3, xmm2 paddq xmm3, xmm1 movq xmm0, qword ptr [r15 + 4*rdx + 16] movq xmm1, qword ptr [r15 + 4*rdx + 24] movq xmm5, qword ptr [rbp + 4*rdx + 16] pcmpeqd xmm5, xmm0 movq xmm6, qword ptr [rbp + 4*rdx + 24] pcmpeqd xmm6, xmm1 pshufd xmm0, xmm5, 212 pandn xmm0, xmm2 paddq xmm0, xmm4 pshufd xmm1, xmm6, 212 pandn xmm1, xmm2 paddq xmm1, xmm3 add rdx, 8 add rsi, -2 jne .LBB11_56 test cl, 1 je .LBB11_59.LBB11_58: movq xmm2, qword ptr [r15 + 4*rdx] movq xmm3, qword ptr [r15 + 4*rdx + 8] movq xmm4, qword ptr [rbp + 4*rdx] pcmpeqd xmm4, xmm2 movq xmm2, qword ptr [rbp + 4*rdx + 8] pcmpeqd xmm2, xmm3 pshufd xmm3, xmm4, 212 movdqa xmm4, xmmword ptr [rip + .LCPI11_0] pandn xmm3, xmm4 paddq xmm0, xmm3 pshufd xmm2, xmm2, 212 pandn xmm2, xmm4 paddq xmm1, xmm2.LBB11_59: paddq xmm0, xmm1 pshufd xmm1, xmm0, 238 paddq xmm1, xmm0 movq rcx, xmm1 cmp rdi, rax je .LBB11_61Assembly-ul pentru funcția hamming_distance_simd arată astfel:
.LBB11_40: cmp rdi, rax ja .LBB11_41 cmp rdi, r12 ja .LBB11_44 movdqu xmm1, xmmword ptr [r15 + 4*rdi - 64] movdqu xmm2, xmmword ptr [r15 + 4*rdi - 48] movdqu xmm3, xmmword ptr [r15 + 4*rdi - 32] movdqu xmm4, xmmword ptr [r15 + 4*rdi - 16] movdqu xmm5, xmmword ptr [r10 + 4*rdi - 64] pcmpeqd xmm5, xmm1 movdqu xmm1, xmmword ptr [r10 + 4*rdi - 48] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r10 + 4*rdi - 32] pcmpeqd xmm2, xmm3 movdqu xmm3, xmmword ptr [r10 + 4*rdi - 16] pcmpeqd xmm3, xmm4 pxor xmm3, xmm0 pxor xmm2, xmm0 packssdw xmm2, xmm3 pxor xmm1, xmm0 pxor xmm5, xmm0 packssdw xmm5, xmm1 packsswb xmm5, xmm2 pmovmskb ebp, xmm5 mov esi, ebp shr esi and esi, 21845 sub ebp, esi mov esi, ebp and esi, 13107 shr ebp, 2 and ebp, 13107 add ebp, esi mov eax, ebp shr eax, 4 add eax, ebp and eax, 3855 mov esi, eax shr esi, 8 add esi, eax movzx eax, sil add r9d, eax add rdi, 16 dec rcx mov rax, qword ptr [rsp + 8] jne .LBB11_40Putem forța și loop unrolling dacă fixăm dimensiunea blocurilor în hamming_distance_simd:
fn hamming_distance_simd(a: &mut Vec, b: &mut Vec) -> u32 { let mut distance: u32 = 0; let lanes = 16; // let chunks = a.len() / lanes; for i in 0..8 { // creează vectori SIMD let a: i32x16 = Simd::from_slice(&a[i*lanes..i*lanes+lanes]); let b: i32x16 = Simd::from_slice(&b[i*lanes..i*lanes+lanes]); // XOR SIMD let z = a.simd_ne(b); distance += z.to_bitmask().count_ones(); } return distance;}Atunci assembly-ul va deveni:
movdqu xmm0, xmmword ptr [r15] movdqu xmm1, xmmword ptr [r15 + 16] movdqu xmm2, xmmword ptr [r15 + 32] movdqu xmm3, xmmword ptr [r15 + 48] movdqu xmm4, xmmword ptr [r14] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 16] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 32] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 48] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb eax, xmm4 mov ecx, eax shr ecx and ecx, 21845 sub eax, ecx mov ecx, eax and ecx, 13107 shr eax, 2 and eax, 13107 add eax, ecx mov ecx, eax shr ecx, 4 add ecx, eax and ecx, 3855 mov eax, ecx shr eax, 8 add eax, ecx movzx eax, al movdqu xmm0, xmmword ptr [r15 + 64] movdqu xmm1, xmmword ptr [r15 + 80] movdqu xmm2, xmmword ptr [r15 + 96] movdqu xmm3, xmmword ptr [r15 + 112] movdqu xmm4, xmmword ptr [r14 + 64] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 80] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 96] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 112] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 128] movdqu xmm1, xmmword ptr [r15 + 144] movdqu xmm2, xmmword ptr [r15 + 160] movdqu xmm3, xmmword ptr [r15 + 176] movdqu xmm4, xmmword ptr [r14 + 128] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 144] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 160] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 176] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 192] movdqu xmm1, xmmword ptr [r15 + 208] movdqu xmm2, xmmword ptr [r15 + 224] movdqu xmm3, xmmword ptr [r15 + 240] movdqu xmm4, xmmword ptr [r14 + 192] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 208] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 224] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 240] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 256] movdqu xmm1, xmmword ptr [r15 + 272] movdqu xmm2, xmmword ptr [r15 + 288] movdqu xmm3, xmmword ptr [r15 + 304] movdqu xmm4, xmmword ptr [r14 + 256] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 272] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 288] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 304] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 320] movdqu xmm1, xmmword ptr [r15 + 336] movdqu xmm2, xmmword ptr [r15 + 352] movdqu xmm3, xmmword ptr [r15 + 368] movdqu xmm4, xmmword ptr [r14 + 320] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 336] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 352] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 368] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 384] movdqu xmm1, xmmword ptr [r15 + 400] movdqu xmm2, xmmword ptr [r15 + 416] movdqu xmm3, xmmword ptr [r15 + 432] movdqu xmm4, xmmword ptr [r14 + 384] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 400] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 416] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 432] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl movzx eax, ax add eax, ecx movdqu xmm0, xmmword ptr [r15 + 448] movdqu xmm1, xmmword ptr [r15 + 464] movdqu xmm2, xmmword ptr [r15 + 480] movdqu xmm3, xmmword ptr [r15 + 496] movdqu xmm4, xmmword ptr [r14 + 448] pcmpeqd xmm4, xmm0 movdqu xmm0, xmmword ptr [r14 + 464] pcmpeqd xmm0, xmm1 movdqu xmm1, xmmword ptr [r14 + 480] pcmpeqd xmm1, xmm2 movdqu xmm2, xmmword ptr [r14 + 496] pcmpeqd xmm2, xmm3 pcmpeqd xmm3, xmm3 pxor xmm2, xmm3 pxor xmm1, xmm3 packssdw xmm1, xmm2 pxor xmm0, xmm3 pxor xmm4, xmm3 packssdw xmm4, xmm0 packsswb xmm4, xmm1 pmovmskb ecx, xmm4 mov edx, ecx shr edx and edx, 21845 sub ecx, edx mov edx, ecx and edx, 13107 shr ecx, 2 and ecx, 13107 add ecx, edx mov edx, ecx shr edx, 4 add edx, ecx and edx, 3855 mov ecx, edx shr ecx, 8 add ecx, edx movzx ecx, cl add ecx, eax mov dword ptr [rsp + 108], ecx lea rax, [rsp + 108] mov qword ptr [rsp + 120], rax mov rax, qword ptr [rip + core::fmt::num::imp::::fmt@GOTPCREL]Se poate observa că prin desfacerea buclei există exact 8 blocuri de cod care folosesc instrucțiuni SIMD. Performanța este puțin mai bună, dar nu cu mult:
/home/denis/.cargo/bin/cargo bench --color=always --package rust_simd --bin rust_simd bench Finished bench [optimized] target(s) in 0.00s Running unittests src/main.rs (target/release/deps/rust_simd-2477d04109c1c861)running 2 teststest bench::simd ... bench: 17 ns/iter (+/- 1)test bench::vanilla ... bench: 0 ns/iter (+/- 0)Concluzii
Sunt încă un începător în Rust, iar drumul meu abia începe. Am încercat să depășesc compilatorul Rust folosind manual instrucțiuni SIMD, dar nu a funcționat prea bine. Rust a reușit să optimizeze și să vectorizeze codul de buclă care nu fusese scris având în vedere instrucțiunile SIMD, iar în final a oferit performanță mult mai bună.
Dacă ai sugestii despre cum pot îmbunătăți codul, te rog să-mi spui în comentarii. 😀
Mulțumesc că ai citit! Spor la programat!
Cod
https://gist.github.com/dnutiu/8fc529d09d2872595cf2bf23d40e1cd2