Un tur al concurenței în Python

Scris de Denis Nuțiu
- 7 minute de citit
- 10 exemple de cod în Python
- 3 imagini
Disponibil și în English
Pe această pagină
Introducere
Salut tuturor! 👋
Acest articol va fi un tur simplu și de bază al modelelor de concurență din Python. Vom începe cu thread-urile, apoi vom trece la procese și, în final, vom acoperi asyncio. Îți voi arăta cum să interacționezi cu aceste mecanisme folosind câteva API-uri de nivel jos, apoi vom trece la API-uri de nivel mai înalt, mai moderne. Îți voi arăta și câteva primitive utilitare pentru sincronizare.
Nu voi acoperi totul, pentru că toate informațiile se găsesc pe site-ul oficial al documentației Python, dar după ce vei citi acest articol vei înțelege bine modelul de concurență din Python.
Thread-uri
Unul dintre modelele principale de concurență sunt thread-urile. Programul tău rulează într-un Process, iar în interiorul procesului există mai multe thread-uri. Deoarece thread-urile rulează în interiorul containerului procesului, ele partajează toate resursele acelui proces.
Thread-urile pot părea că rulează în paralel, în același timp, dar de fapt nu o fac. Python are GIL (Global Interpreter Lock) și, din cauza lui, doar un thread rulează la un moment dat. Totuși, pentru că trec de la unul la altul atât de repede, pare că rulează în paralel.
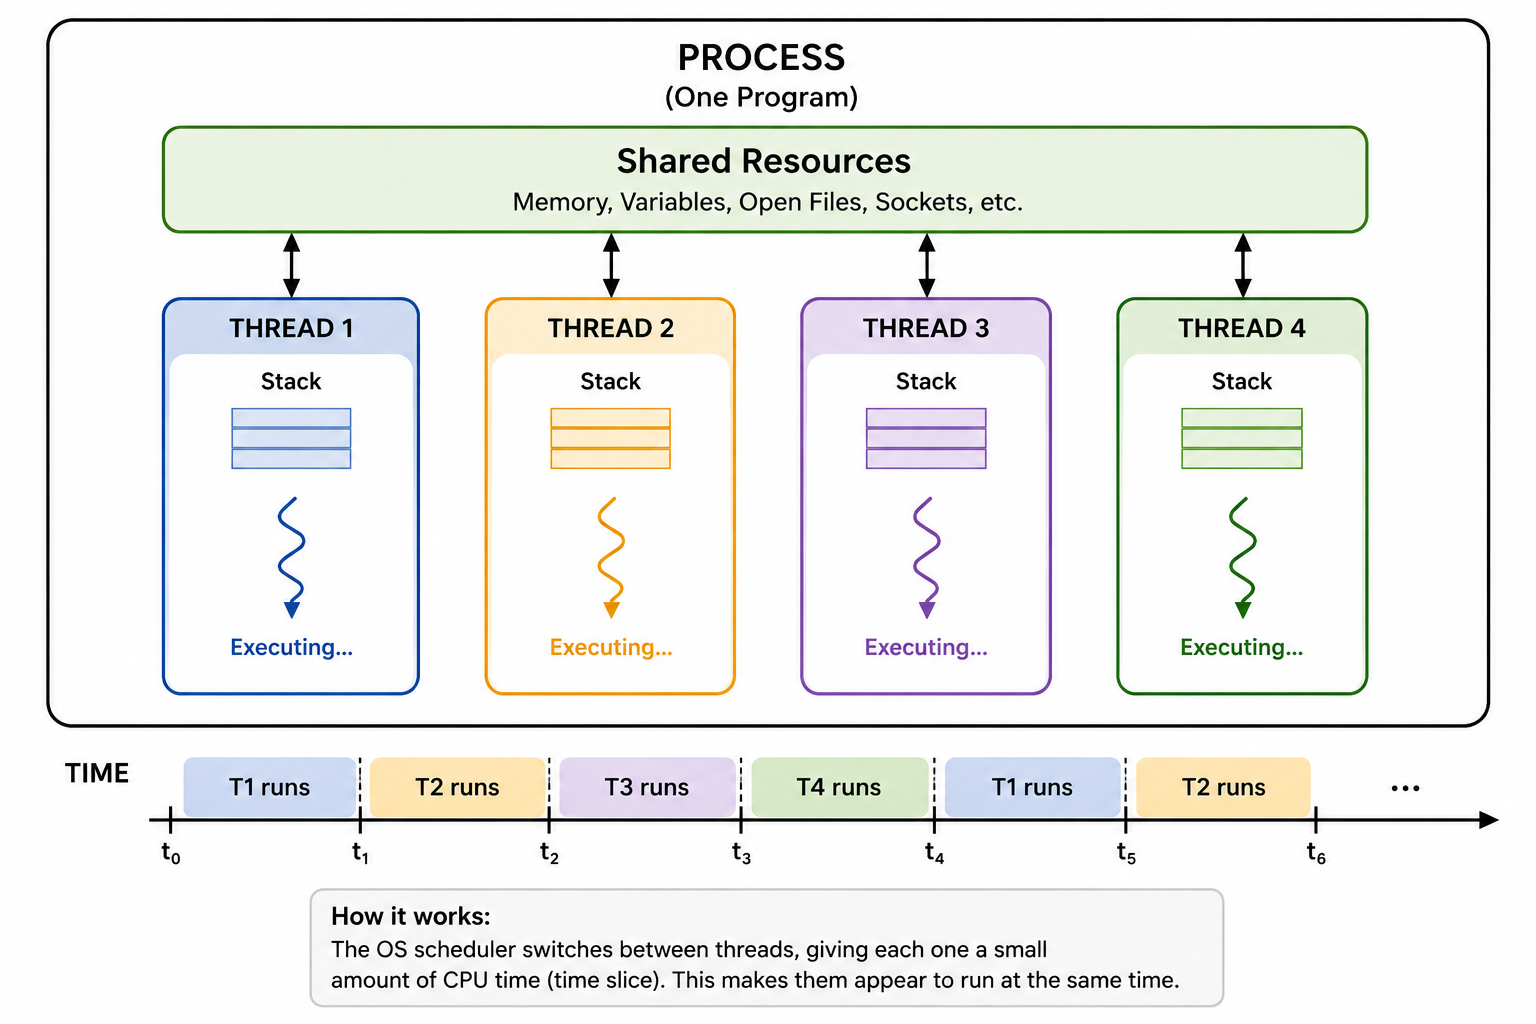
Pe vremuri, calculatoarele aveau un singur nucleu de CPU, iar sistemul de operare și aplicațiile îl partajau. Codul putea rula doar pe un nucleu, iar pentru ca sistemul de operare să permită multitasking-ul trebuia să aloce fiecărei aplicații o fereastră de timp pe nucleu. Același lucru se întâmplă și astăzi, dar acum avem acces la mai multe nuclee și putem rula lucrurile în paralel.
În alte limbaje, precum Java, thread-urile puteau fi programate pe nuclee diferite, ceea ce le făcea să ruleze în paralel. Dar în Python, din cauza GIL-ului, se permite doar un thread să ruleze în același timp pe fiecare proces.
Thread-urile sunt ușoare în comparație cu procesele, dar sunt costisitoare în comparație cu corutinele.
| Coroutine | Thread | Process | |
|---|---|---|---|
| Creare | Foarte ieftină | Moderată | Costisitoare |
| Memorie | Foarte mică | Mai mare | Mult mai mare |
| Schimbare de context | Foarte ieftină | La nivel de OS, mai costisitoare | La nivel de OS, cea mai costisitoare |
| Spațiu de memorie | Partajat | Partajat | Separat |
| Programare | Event loop | OS | OS |
| Scară tipică | Mii–milioane* | Sute–mii | De obicei relativ puține |
Deoarece la crearea unui thread trebuie să creezi și resursele partajate, fiecare thread are propria stivă, iar acest lucru nu scalează bine dacă încerci să creezi un milion de thread-uri. Codul sistemului de operare care gestionează thread-urile trebuie, de asemenea, să le programeze, iar dacă există multe thread-uri de programat, se ajunge la un blocaj și performanța scade. Același lucru se întâmplă și cu procesele.
Un fork bomb este un fel de „virus” care se tot bifurcă (fork) la nesfârșit. Sistemul de operare va crea procese până când toate resursele se epuizează, iar acestea nu mai pot fi programate în mod fiabil, ceea ce forțează sistemul să se blocheze.
Thread
Acesta este un exemplu de cod care pornește două thread-uri; ținta este funcția thread_target, care va fi rulată pe cele
două thread-uri.
import randomfrom threading import Threadclass Program: def __init__(self): self._shared_x = 2 def thread_target(self): print("Hello from thread") for i in range(1_000_000): self._shared_x += random.randint(0, i) def main(self): th_one = Thread(target=self.thread_target) th_two = Thread(target=self.thread_target) th_one.start() th_two.start() th_one.join() th_two.join() print("Shared X:", self._shared_x)if __name__ == '__main__': program = Program() program.main()Trebuie să facem join la thread-uri, pentru că dacă nu le facem, thread-ul principal se termină, procesul se oprește, iar celelalte două thread-uri rămân orfane.
Timer
Timer este o clasă utilitară utilă atunci când vrei să programezi o acțiune. Pornește propriul thread și execută acea acțiune. Este util pentru implementarea heartbeat-urilor sau pentru verificarea unor lucruri, cum ar fi reînnoirea tokenurilor de autorizare.
Iată un exemplu simplu de cod pentru afișarea unui heartbeat:
from threading import Timerfrom time import sleepclass Program: def __init__(self): self._timer: Timer | None = Timer(5, self.heartbeat) def heartbeat(self): print("Heartbeat") self._timer = Timer(5, self.heartbeat) self._timer.start() def run(self): print("Running the program.") self._timer.start() while True: sleep(1) def stop(self): self._timer.cancel() self._timer = Noneif __name__ == "__main__": program = Program() try: program.run() except KeyboardInterrupt: program.stop()Concurrent Futures: Thread Pool
Acest exemplu este similar cu primul, dar folosește un API de nivel mai înalt pentru programarea thread-urilor.
import randomfrom concurrent.futures import ThreadPoolExecutorclass Program: def __init__(self): self._shared_x = 2 def thread_target(self, low): print("Hello from thread") for i in range(1_000_000): self._shared_x += random.randint(min(low, i), i) return self._shared_x def main(self): th_pool = ThreadPoolExecutor(max_workers=5) th_one = th_pool.submit(self.thread_target, 0) th_two = th_pool.submit(self.thread_target,2) print("Shared X after first thread", th_one.result()) print("Shared X after second thread", th_two.result()) print("Shared X:", self._shared_x)if __name__ == '__main__': program = Program() program.main()Se inițializează și un thread pool de dimensiune fixă. Ce returnează pool.submit este un Future. Poți verifica rezultatul
future-ului folosind .result(), sau excepția cu .exception().
Documentația conține toate funcțiile detaliate pe care le poți apela pe un obiect Future.
Procese
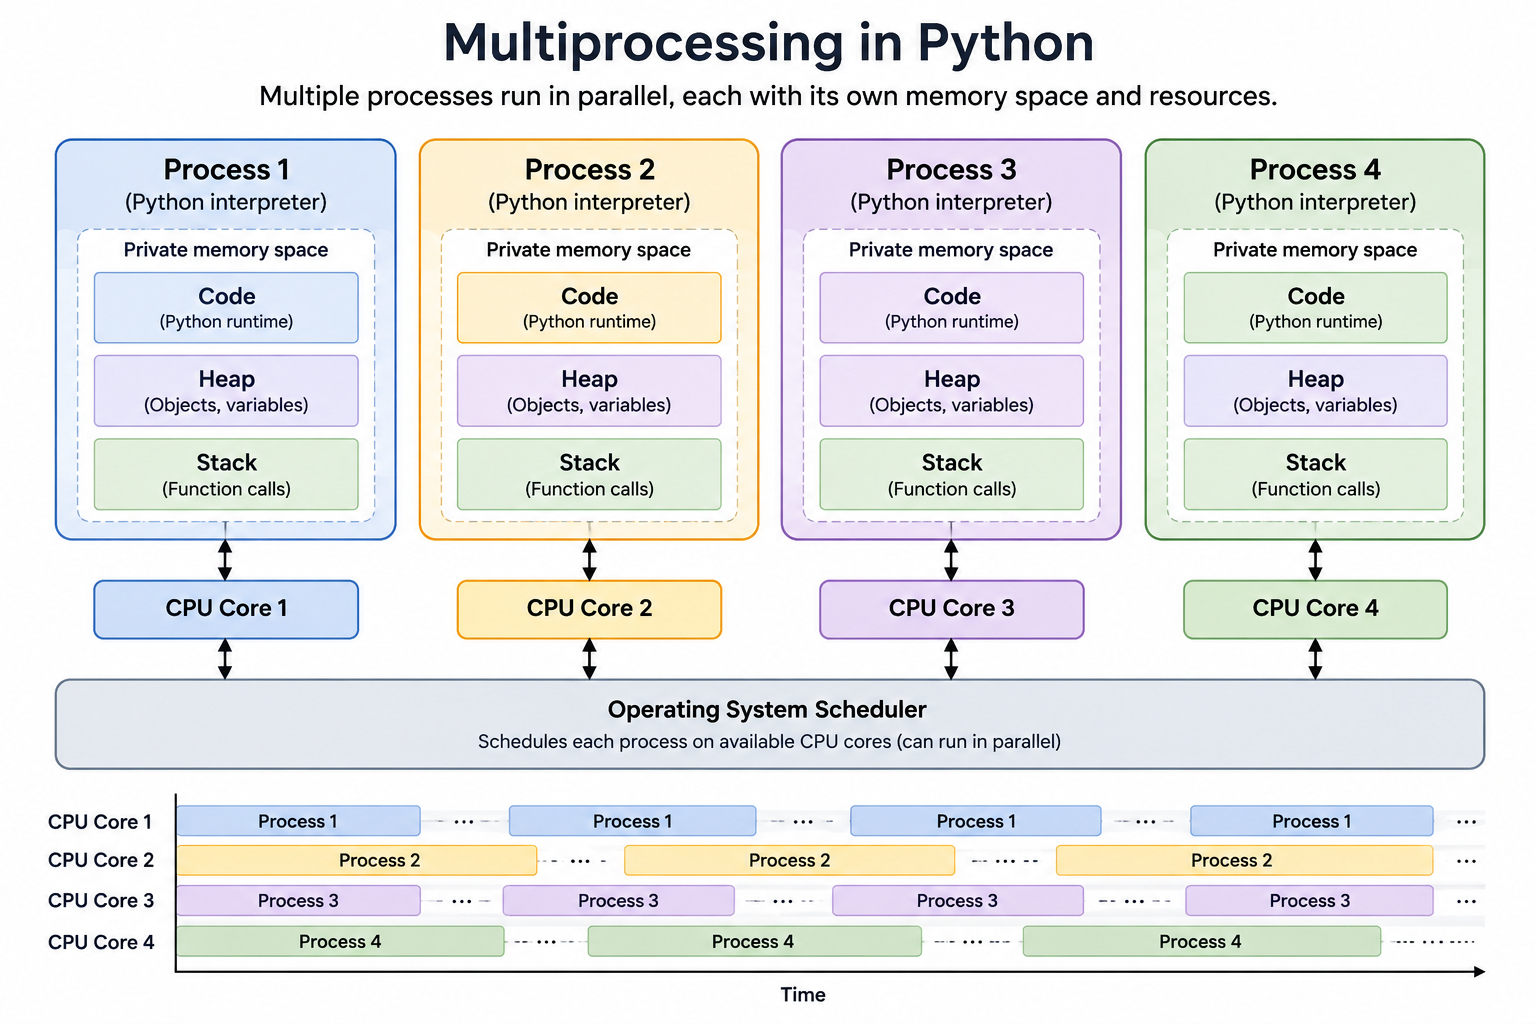
Procesele sunt gestionate de sistemul de operare și servesc drept container pentru thread-uri. Ele sunt folosite pentru a rula lucruri în paralel. Poți ocoli limitările GIL-ului Python împărțind munca pe mai multe procese, iar dacă munca ta implică multă activitate de I/O sau de rețea, poți porni un loop asincron în fiecare proces.
Crearea mai multor procese este o modalitate excelentă de a aborda o sarcină legată de CPU, iar pentru că sunt gestionate de OS, fiecare proces rulează pe propriul nucleu. Dacă ai mai multe procese decât nuclee disponibile, atunci fiecare proces va primi o fereastră de timp pe nucleul CPU.
Procesele au propria memorie privată, dar API-ul îți permite să partajezi o parte din memorie cu alte procese. Pentru comunicarea între procese poți folosi Queues și Pipes.
Multiprocessing
API-ul multiprocessing este similar cu API-ul threading. Poți porni procese individuale sau poți folosi un pool de procese.
from multiprocessing import Processdef f(name): print('hello', name)if __name__ == '__main__': p = Process(target=f, args=('bob',)) p.start() p.join()Și un exemplu de pool de procese:
from multiprocessing import Pooldef f(x): return x*xif __name__ == '__main__': with Pool(5) as p: print(p.map(f, [1, 2, 3]))Exemplele sunt copiate din documentația oficială Python despre multiprocessing, care este o excelentă analiză detaliată a subiectului.
Concurrent Futures: Process Pool
Poți folosi același API concurrent.futures pentru a crea un pool de procese, așa cum ai crea un thread pool. În acest exemplu merită observat că variabila _shared_x nu este de fapt partajată: fiecare proces primește propria copie, iar procesul principal nu o modifică deloc.
import randomfrom concurrent.futures import ProcessPoolExecutorclass Program: def __init__(self): self._shared_x = 2 def target(self, low): print("Hello from process") for i in range(1_000_000): self._shared_x += random.randint(min(low, i), i) return self._shared_x def main(self): process_pool = ProcessPoolExecutor(max_workers=5) th_one = process_pool.submit(self.target, 0) th_two = process_pool.submit(self.target,2) print("Shared X after first process", th_one.result()) print("Shared X after second process", th_two.result()) print("Shared X:", self._shared_x)if __name__ == '__main__': program = Program() program.main()Dacă rulezi exemplul, ar trebui să afișeze ceva de genul:
Hello from processHello from processShared X after first process 250199267754Shared X after second process 249818236816Shared X: 2Asyncio
Asyncio este unul dintre modelele mele preferate de concurență în Python. Când dezvolți servicii web, de obicei vrei să servești mai mulți utilizatori în același timp. Înainte ca acest model să fie folosit, acest lucru se realiza creând un thread sau un proces pentru fiecare cerere. Funcționa bine, dar nu scala bine: există o limită a numărului de procese pe care le putem crea și programa, și același lucru este valabil și pentru thread-uri.
Și hai să fim sinceri: cu API-urile web de astăzi, majoritatea cererilor înseamnă doar preluarea unor date dintr-o bază de date sau cache, un apel de rețea sau calcule numerice. Crearea unui proces nou pentru fiecare cerere ar fi exagerat.
O aplicație construită cu asyncio în minte folosește de obicei un singur proces, iar pe acel proces rulează event loop-ul; în loc de thread-uri, folosim corutine, care sunt similare.
Thread-urile sunt de obicei gestionate de sistemul de operare, ceea ce este mai puțin eficient, iar corutinele sunt gestionate de
interpretorul Python. Thread-urile sunt întrerupte de OS pentru a permite rularea altor thread-uri/procese, iar corutinele îți spun
exact când pot fi întrerupte, folosind un cuvânt cheie precum await.
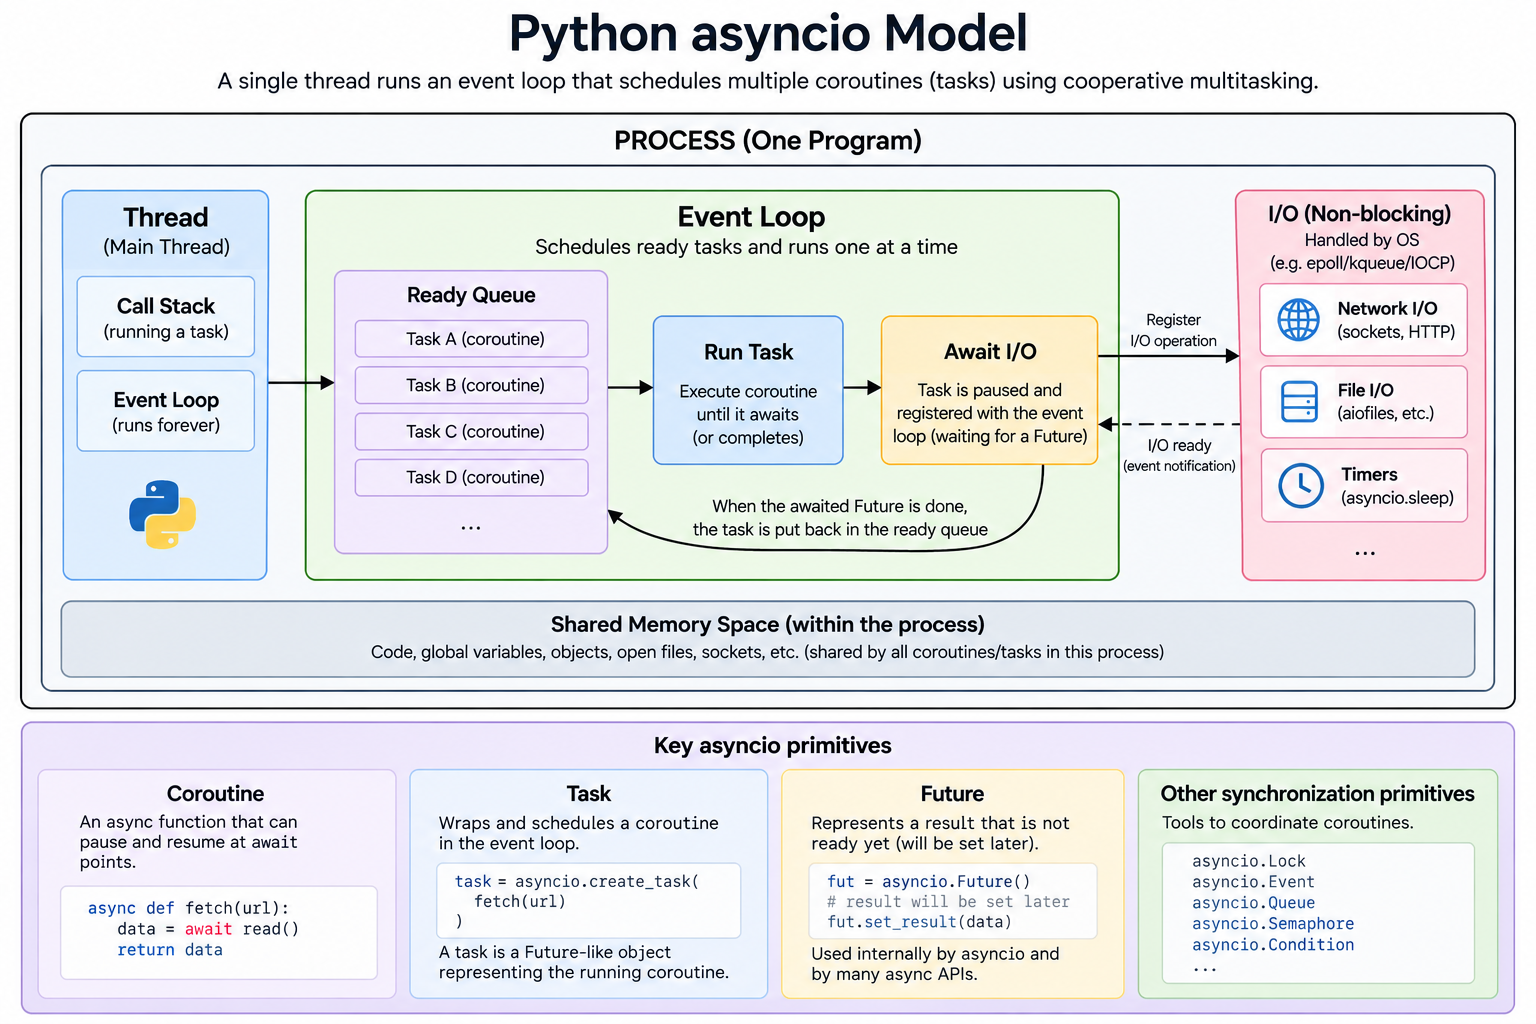
Când o corutină cedează voluntar execuția înapoi event loop-ului, event loop-ul alege o altă corutină să ruleze.
Este foarte important ca, atunci când folosești acest model, corutina să nu blocheze event loop-ul, nefiind niciodată await-ată
pe alte sarcini sau petrecând mult timp cu calcule numerice, pentru că event loop-ul are un singur thread, iar asta înseamnă că celelalte
lucruri nu mai vor rula.
Acest model funcționează excelent pentru aplicațiile web, pentru că servesc cererile în paralel, dar dacă scrii un script simplu care face cereri în mod sincron, nu vei câștiga prea mult, de exemplu:
import asyncioasync def task(): await fetch_data() # wait until finished await fetch_data() # then start this await fetch_data() await fetch_data() asyncio.run(task())Dacă poți, rulează toate cererile în paralel cu asyncio.gather sau cu alternativa mai modernă TaskGroup.
async def fetch_data(n): print(f"Fetching {n}") await asyncio.sleep(1) print(f"Finished {n}") return nasync def main(): results = await asyncio.gather( fetch_data(1), fetch_data(2), fetch_data(3), fetch_data(4), ) print(results)asyncio.run(main())import asyncioasync def fetch_data(n): print(f"Fetching {n}") await asyncio.sleep(1) print(f"Finished {n}") return nasync def main(): async with asyncio.TaskGroup() as tg: task1 = tg.create_task(fetch_data(1)) task2 = tg.create_task(fetch_data(2)) task3 = tg.create_task(fetch_data(3)) task4 = tg.create_task(fetch_data(4)) print(task1.result()) print(task2.result()) print(task3.result()) print(task4.result())asyncio.run(main())Concluzie
Sper că acest articol ți-a oferit o introducere de bază în modelele de concurență din Python. Nu am acoperit primitivele de sincronizare; de obicei am folosit doar mutex-ul, asyncio.shield și asyncio.Lock. În opinia mea, atunci când scrii aplicații pentru utilizatori și servicii web, este mai bine să păstrezi lucrurile mai simple.
Documentația oficială Python este o resursă excelentă pentru a aprofunda aceste subiecte.
Mulțumesc că ai citit!