Construirea unui pipeline RAG

Scris de Denis Nuțiu
- 7 minute de citit
- 7 exemple de cod în Shell și Python
- 6 imagini
Disponibil și în English
Pe această pagină
Introducere
Salut tuturor! 👋
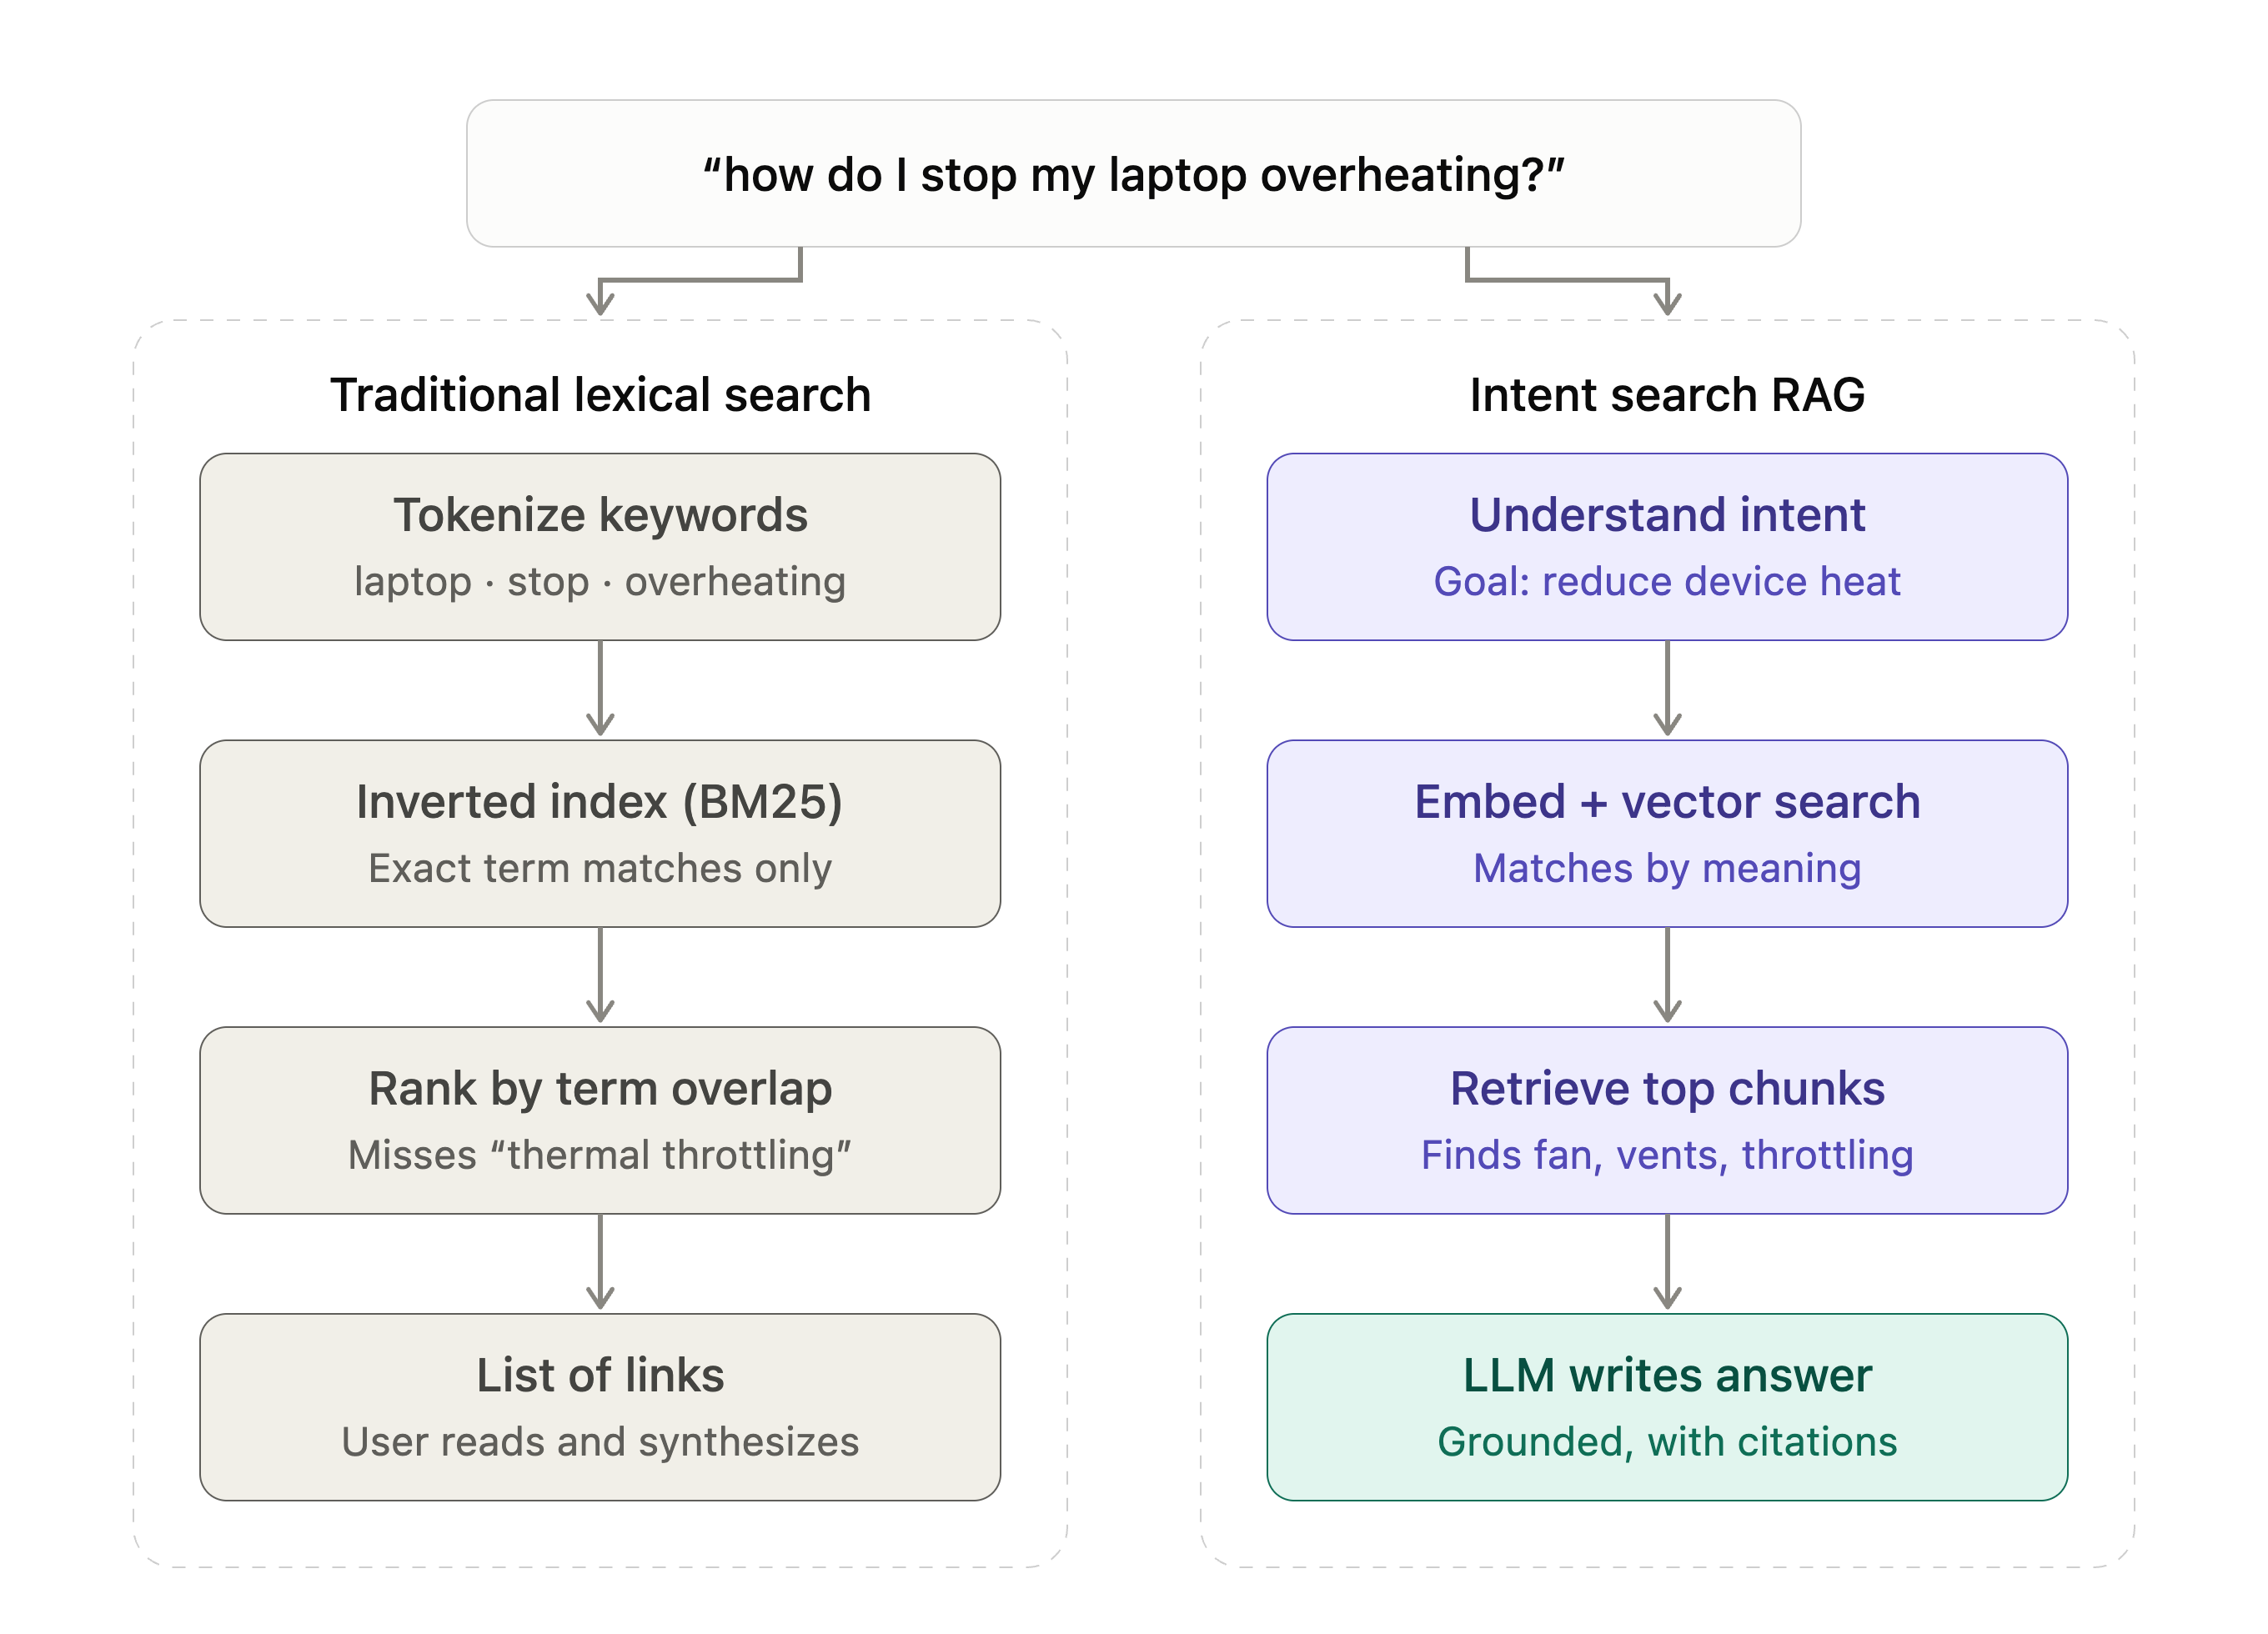
Am vrut să scriu acest articol ca să arăt cum se construiește un pipeline RAG (Retrieval Augmented Generation, adică generare augmentată prin regăsire de informații). Un motiv pentru care ai dori să îl construiești este să activezi căutarea după intenție pentru afacerea sau proiectul tău.
Uneori RAG funcționează cel mai bine împreună cu căutarea lexicală, metoda tradițională de căutare în care se construiește un index inversat, iar rezultatele sunt ordonate cu un algoritm precum BM25+.
Principalul avantaj al RAG este că agenții pot căuta în cantități mari de date după intenție, dar și oamenii pot. Îl poți folosi și fără agenți.
Proiectul
Ca să mă joc cu asta, am vrut să indexez o carte, și am ales Frații Karamazov de Fiodor Dostoievski, iar spre rușinea mea nu am citit-o.
Din fericire, am găsit-o pe Project Gutenberg și putem folosi textul gratuit.
Poți descărca textul de pe site și îl poți salva ca fișier. Am mai făcut și o curățare suplimentară: am șters din date introducerea, încheierea și cuprinsul.
În funcție de modelul folosit pentru generarea embedding-urilor, dacă este un model multilingv, utilizatorii pot pune întrebări despre date în practic orice limbă.
Pașii
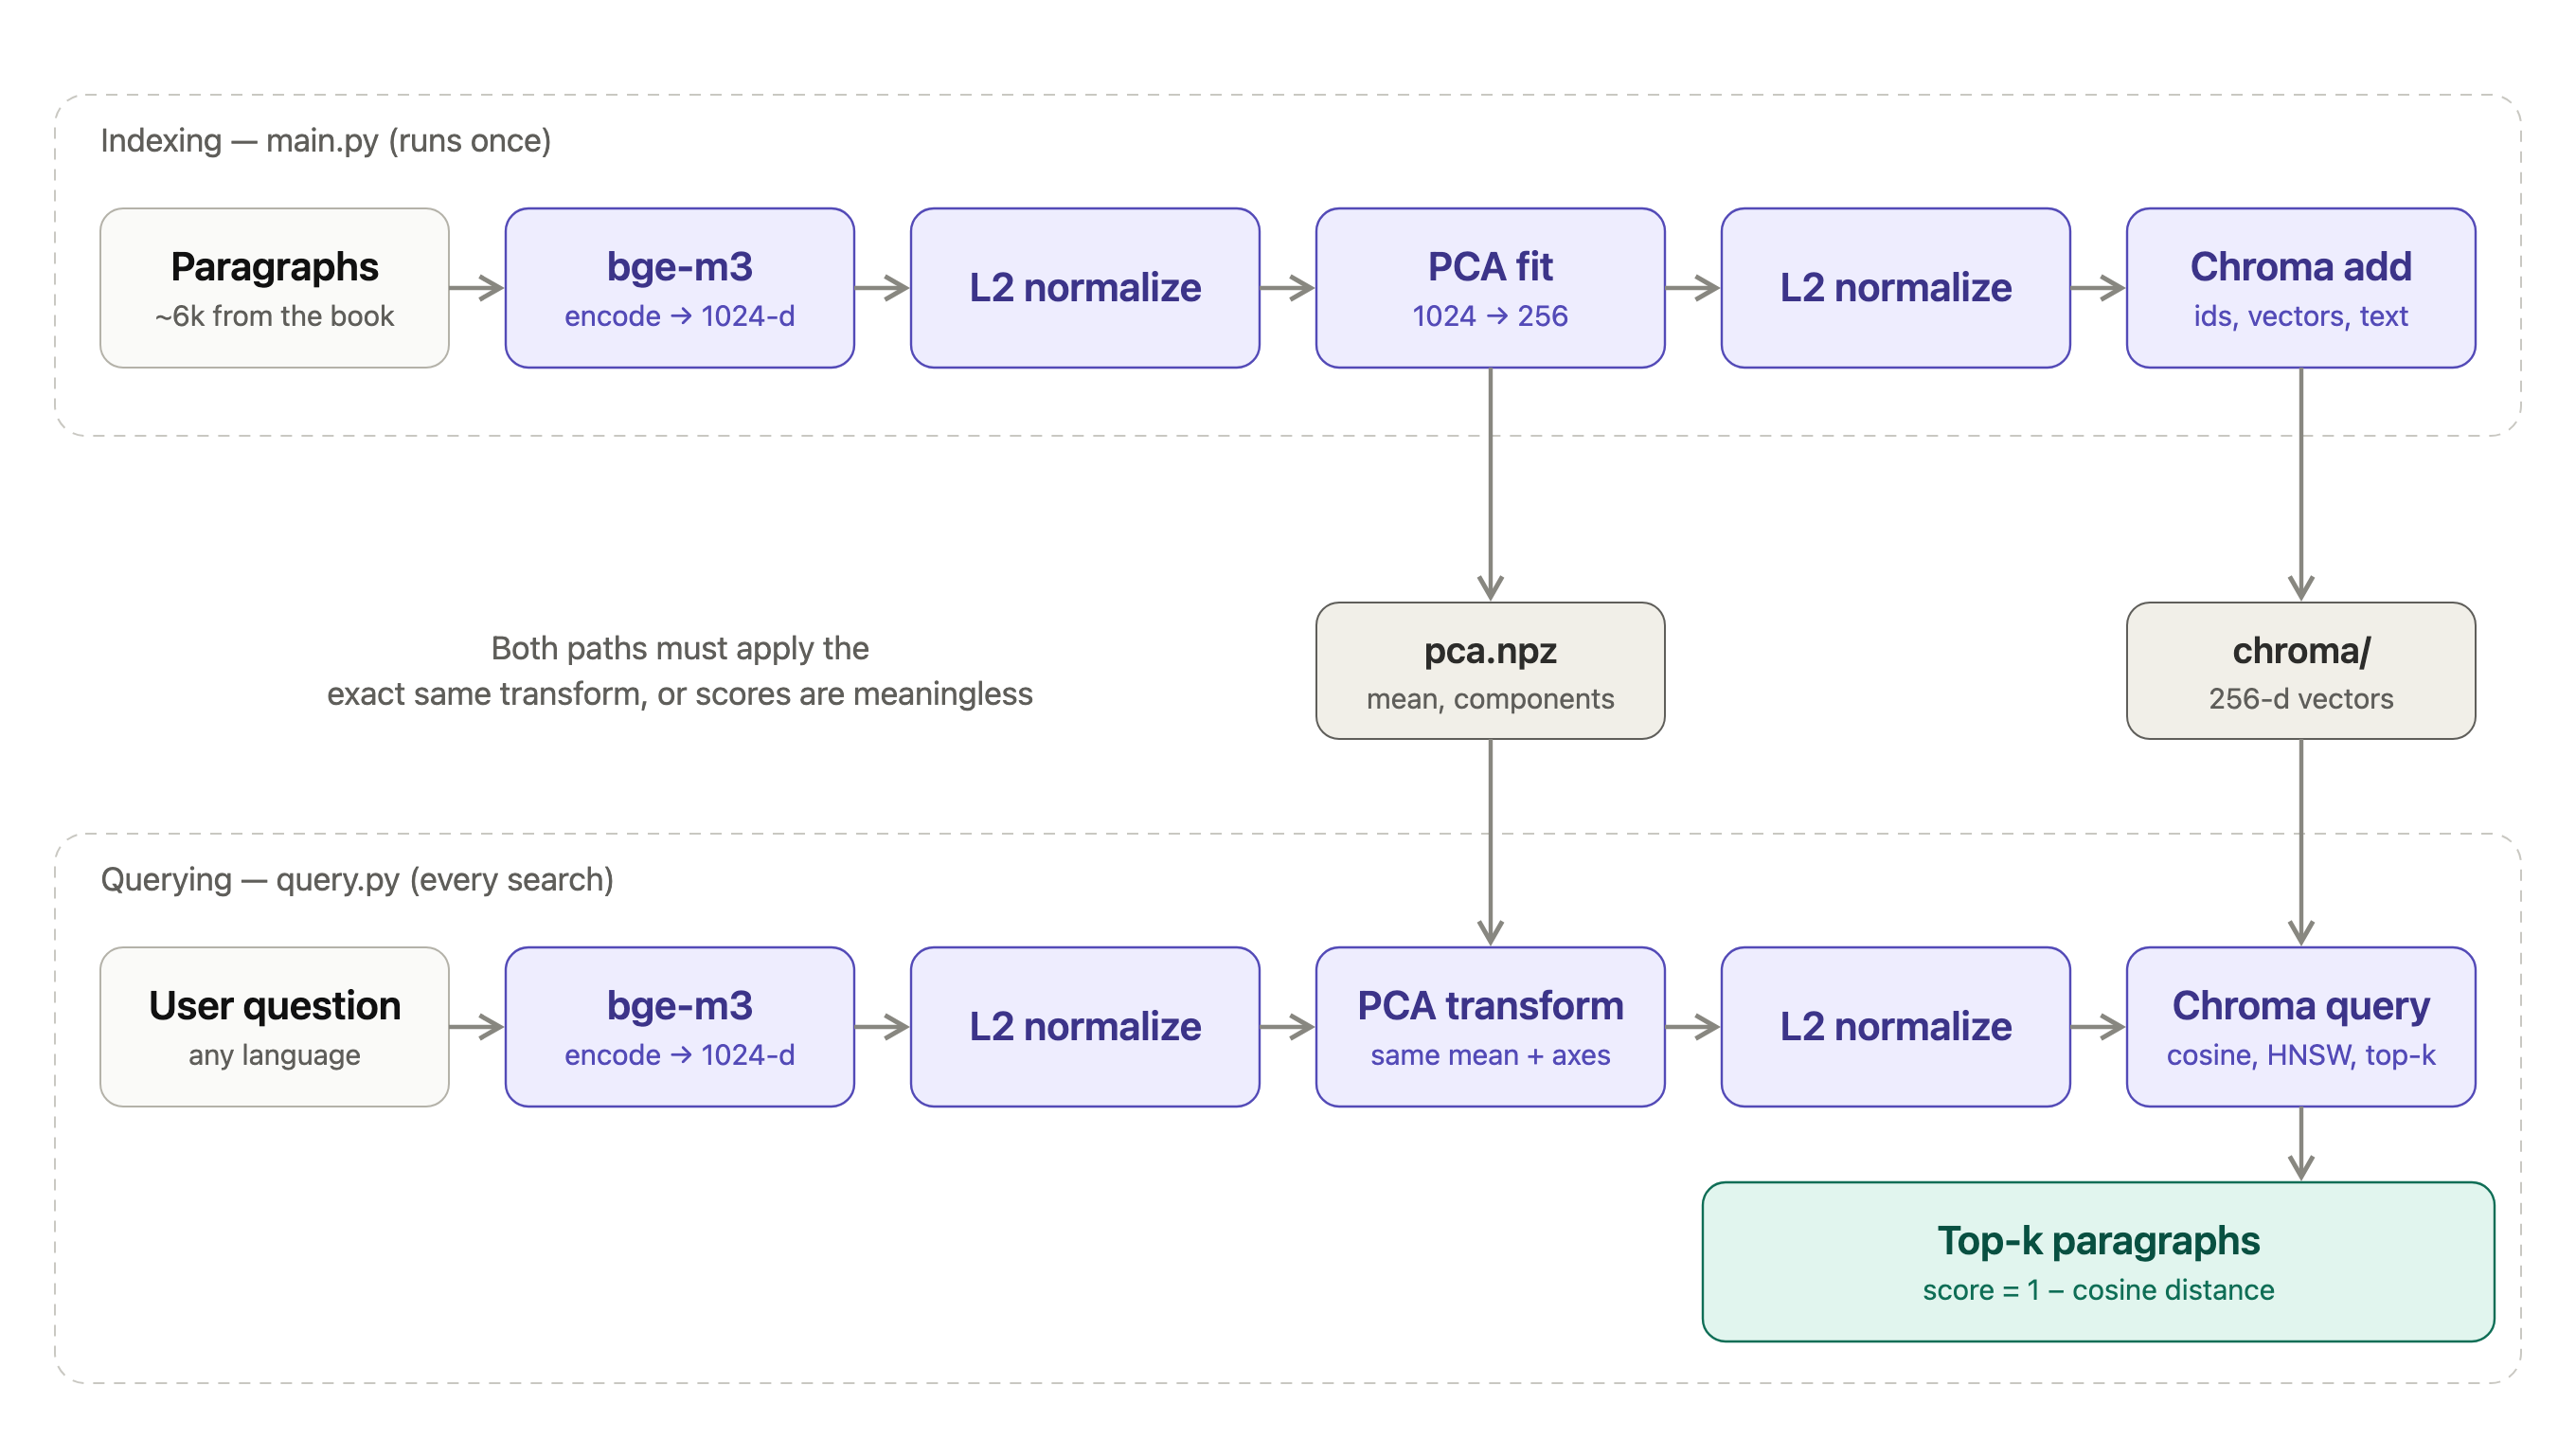
Ca să implementăm pipeline-ul RAG vom parcurge următorii pași:
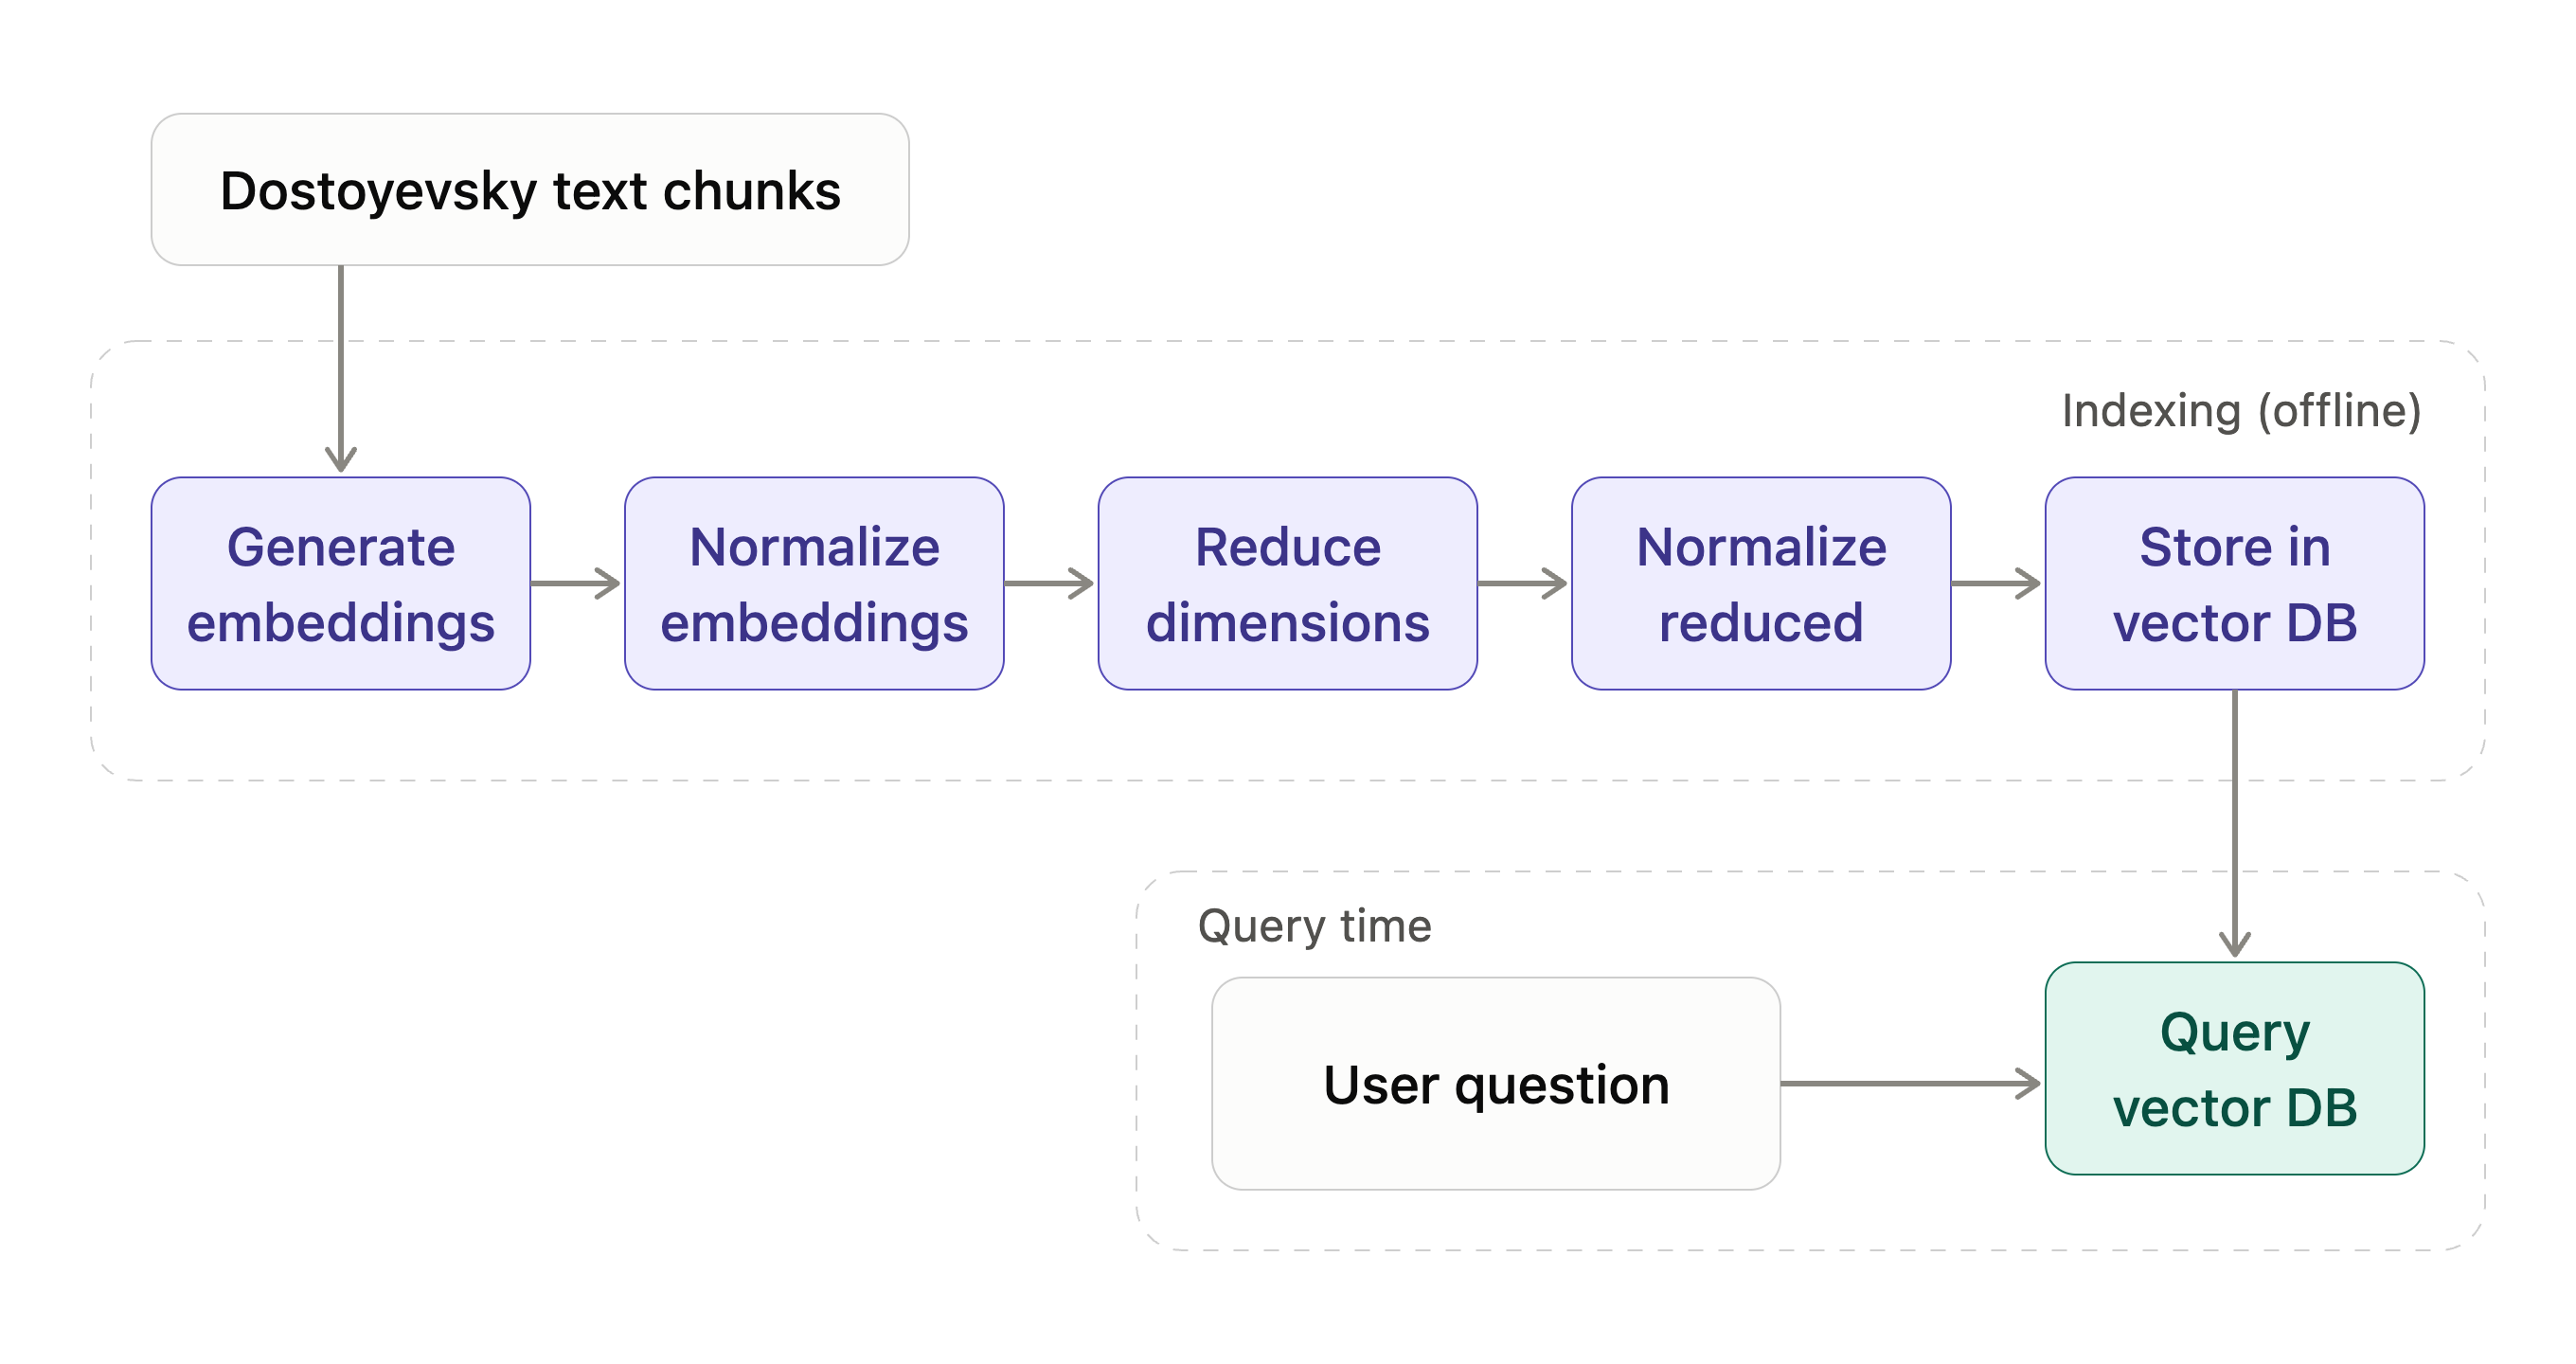
Pe scurt, pașii sunt:
- Vom genera embedding-urile folosind o bibliotecă Python open source, FlagEmbedding, și un model numit “BAAI/bge-m3”.
- Vom normaliza vectorii folosind norma L2.
- Vom reduce dimensiunea de la 1024 la 256. Acesta este un compromis între acuratețe și viteză.
- Normalizăm din nou.
- Stocăm embedding-urile finale într-o bază de date vectorială locală: chromadb.
Când interogăm indexul RAG, avem nevoie de același model pentru a genera embedding-ul interogării utilizatorului și de fișierul PCA pentru a reduce dimensiunea embedding-ului generat la 256. Apoi cerem chromadb cei mai apropiați vecini pentru interogarea utilizatorului.
Generarea embedding-urilor
Am folosit Python 3.14 și următoarele dependențe:
uv add FlagEmbeddinguv add scikit-learnuv add chromadbUrmătorul fragment de cod Python construiește pipeline-ul descris mai sus.
def main(): paragraphs = load_paragraphs(SOURCE_TEXT) print(f"Loaded {len(paragraphs)} paragraphs from {SOURCE_TEXT}") model = BGEM3FlagModel(EMBEDDING_MODEL, normalize_embeddings=False, use_fp16=True) output = model.encode_corpus(paragraphs, batch_size=32, max_length=MAX_LENGTH) embeddings = l2_normalize(output["dense_vecs"]) print(f"Embeddings shape: {embeddings.shape}") pca = PCA(n_components=PCA_COMPONENTS) embeddings = l2_normalize(pca.fit_transform(embeddings)) norms = np.linalg.norm(embeddings, axis=1) print( f"After PCA: shape {embeddings.shape}, " f"explained variance {pca.explained_variance_ratio_.sum():.1%}, " f"L2 norms in [{norms.min():.6f}, {norms.max():.6f}]" ) np.savez(PCA_FILE, mean=pca.mean_, components=pca.components_) print(f"Saved PCA projection to {PCA_FILE}") # Reconstruim colecția la fiecare rulare, ca să corespundă mereu cu PCA salvat mai sus. client = chromadb.PersistentClient(path=str(CHROMA_PATH)) if COLLECTION_NAME in [collection.name for collection in client.list_collections()]: client.delete_collection(COLLECTION_NAME) # Vectorii provin de la bge-m3 + PCA, deci Chroma nu trebuie să genereze nimic singură. collection = client.create_collection( COLLECTION_NAME, configuration={"hnsw": {"space": "cosine"}}, embedding_function=None ) batch_size = client.get_max_batch_size() for start in range(0, len(paragraphs), batch_size): indices = range(start, min(start + batch_size, len(paragraphs))) collection.add( ids=[f"paragraph-{i}" for i in indices], embeddings=embeddings[indices.start : indices.stop], documents=paragraphs[indices.start : indices.stop], metadatas=[{"paragraph": i} for i in indices], ) print(f"Stored {collection.count()} paragraphs in collection {COLLECTION_NAME!r} at {CHROMA_PATH}")Rularea codului va scrie toate embedding-urile într-o bază de date vectorială locală, încorporată, chromadb, și va salva fișierul PCA pe disc. Am aplicat PCA asupra embedding-urilor ca să facem un compromis între acuratețe și viteză. Procesarea unui vector de 1024 de elemente necesită mai mult calcul, așa că am aplicat PCA ca să reducem dimensiunea la 256 de elemente.
Interogarea embedding-urilor
Utilizatorul poate interoga embedding-urile printr-un MCP, un API web sau o interfață CLI simplă. Deocamdată folosim varianta CLI, pentru că avem baza de date locală și fișierul PCA, de care avem nevoie ca să construim vectorul de interogare.
def main() -> None: parser = argparse.ArgumentParser(description="Search The Brothers Karamazov by meaning.") parser.add_argument("query", help="the text to search for") parser.add_argument("-k", "--top-k", type=int, default=5, help="number of paragraphs to return") args = parser.parse_args() client = chromadb.PersistentClient(path=str(CHROMA_PATH)) try: collection = client.get_collection(COLLECTION_NAME, embedding_function=None) except NotFoundError: raise SystemExit(f"No collection {COLLECTION_NAME!r} in {CHROMA_PATH}; run main.py first") pca = np.load(PCA_FILE) model = BGEM3FlagModel(EMBEDDING_MODEL, normalize_embeddings=False, use_fp16=True) query_vector = embed_query(args.query, model, pca["mean"], pca["components"]) results = collection.query( query_embeddings=[query_vector], n_results=args.top_k, include=["documents", "metadatas", "distances"], ) hits = zip(results["documents"][0], results["metadatas"][0], results["distances"][0]) for rank, (document, metadata, distance) in enumerate(hits, start=1): # Colecția folosește distanța cosinus, deci 1 - distanța este similaritatea cosinus. print(f"\n#{rank} paragraph {metadata['paragraph']} score {1 - distance:.3f}") print(textwrap.fill(document, width=100))Putem interoga baza de date cu:
uv run src/ragpipeline/query.py "Ivan's poem about the Grand Inquisitor"Scriptul va crea un embedding pentru interogare, va aplica norma L2, PCA, apoi din nou norma L2, și apoi va interoga chroma db.
Interogarea va returna:
#2 paragraph 1705 score 0.555“My poem is called ‘The Grand Inquisitor’; it’s a ridiculous thing, but I want to tell it to you.”#5 paragraph 5220 score 0.478“My dear fellow, I know a most charming and attractive young Russian gentleman, a young thinker anda great lover of literature and art, the author of a promising poem entitled _The Grand Inquisitor_.I was only thinking of him!”Exemple de interogări
Iată o altă interogare, de data aceasta în română: „L-au plătit”, adică a fost plătit sau cumpărat.
uv run src/ragpipeline/query.py "L-au platit"#1 paragraph 630 score 0.492“Pay back the three thousand.”#2 paragraph 645 score 0.454“It was he told you about the money, then?”Am primit câteva rezultate legate de bani, ceea ce este destul de tare. Și ultima interogare, tot în română: „Care sunt partenerele lui Fyodor?”
uv run src/ragpipeline/query.py "Care sunt partenerele lui Fyodor?"#3 paragraph 1 score 0.393He was married twice, and had three sons, the eldest, Dmitri, by his first wife, and two, Ivan andAlexey, by his second. Fyodor Pavlovitch’s first wife, Adelaïda Ivanovna, belonged to a fairly richand distinguished noble family, also landowners in our district, the Miüsovs. How it came to passthat an heiress, who was also a beauty, and moreover one of those vigorous, intelligent girls, socommon in this generation, but sometimes also to be found in the last, could have married such aworthless, puny weakling, as we all called him, I won’t attempt to explain. I knew a young lady ofthe last “romantic” generation who after some years of an enigmatic passion for a gentleman, whomshe might quite easily have married at any moment, invented insuperable obstacles to their union,and ended by throwing herself one stormy night into a rather deep and rapid river from a high bank,almost a precipice, and so perished, entirely to satisfy her own caprice, and to be likeShakespeare’s Ophelia. Indeed, if this precipice, a chosen and favorite spot of hers, had been lesspicturesque, if there had been a prosaic flat bank in its place, most likely the suicide would neverhave taken place. This is a fact, and probably there have been not a few similar instances in thelast two or three generations. Adelaïda Ivanovna Miüsov’s action was similarly, no doubt, an echo ofother people’s ideas, and was due to the irritation caused by lack of mental freedom. She wanted,perhaps, to show her feminine independence, to override class distinctions and the despotism of herfamily. And a pliable imagination persuaded her, we must suppose, for a brief moment, that FyodorPavlovitch, in spite of his parasitic position, was one of the bold and ironical spirits of thatprogressive epoch, though he was, in fact, an ill-natured buffoon and nothing more. What gave themarriage piquancy was that it was preceded by an elopement, and this greatly captivated AdelaïdaIvanovna’s fancy. Fyodor Pavlovitch’s position at the time made him specially eager for any suchenterprise, for he was passionately anxious to make a career in one way or another. To attachhimself to a good family and obtain a dowry was an alluring prospect. As for mutual love it did notexist apparently, either in the bride or in him, in spite of Adelaïda Ivanovna’s beauty. This was,perhaps, a unique case of the kind in the life of Fyodor Pavlovitch, who was always of a voluptuoustemper, and ready to run after any petticoat on the slightest encouragement. She seems to have beenthe only woman who made no particular appeal to his senses.#4 paragraph 676 score 0.389Alyosha rose, but Fyodor Pavlovitch had already changed his mind.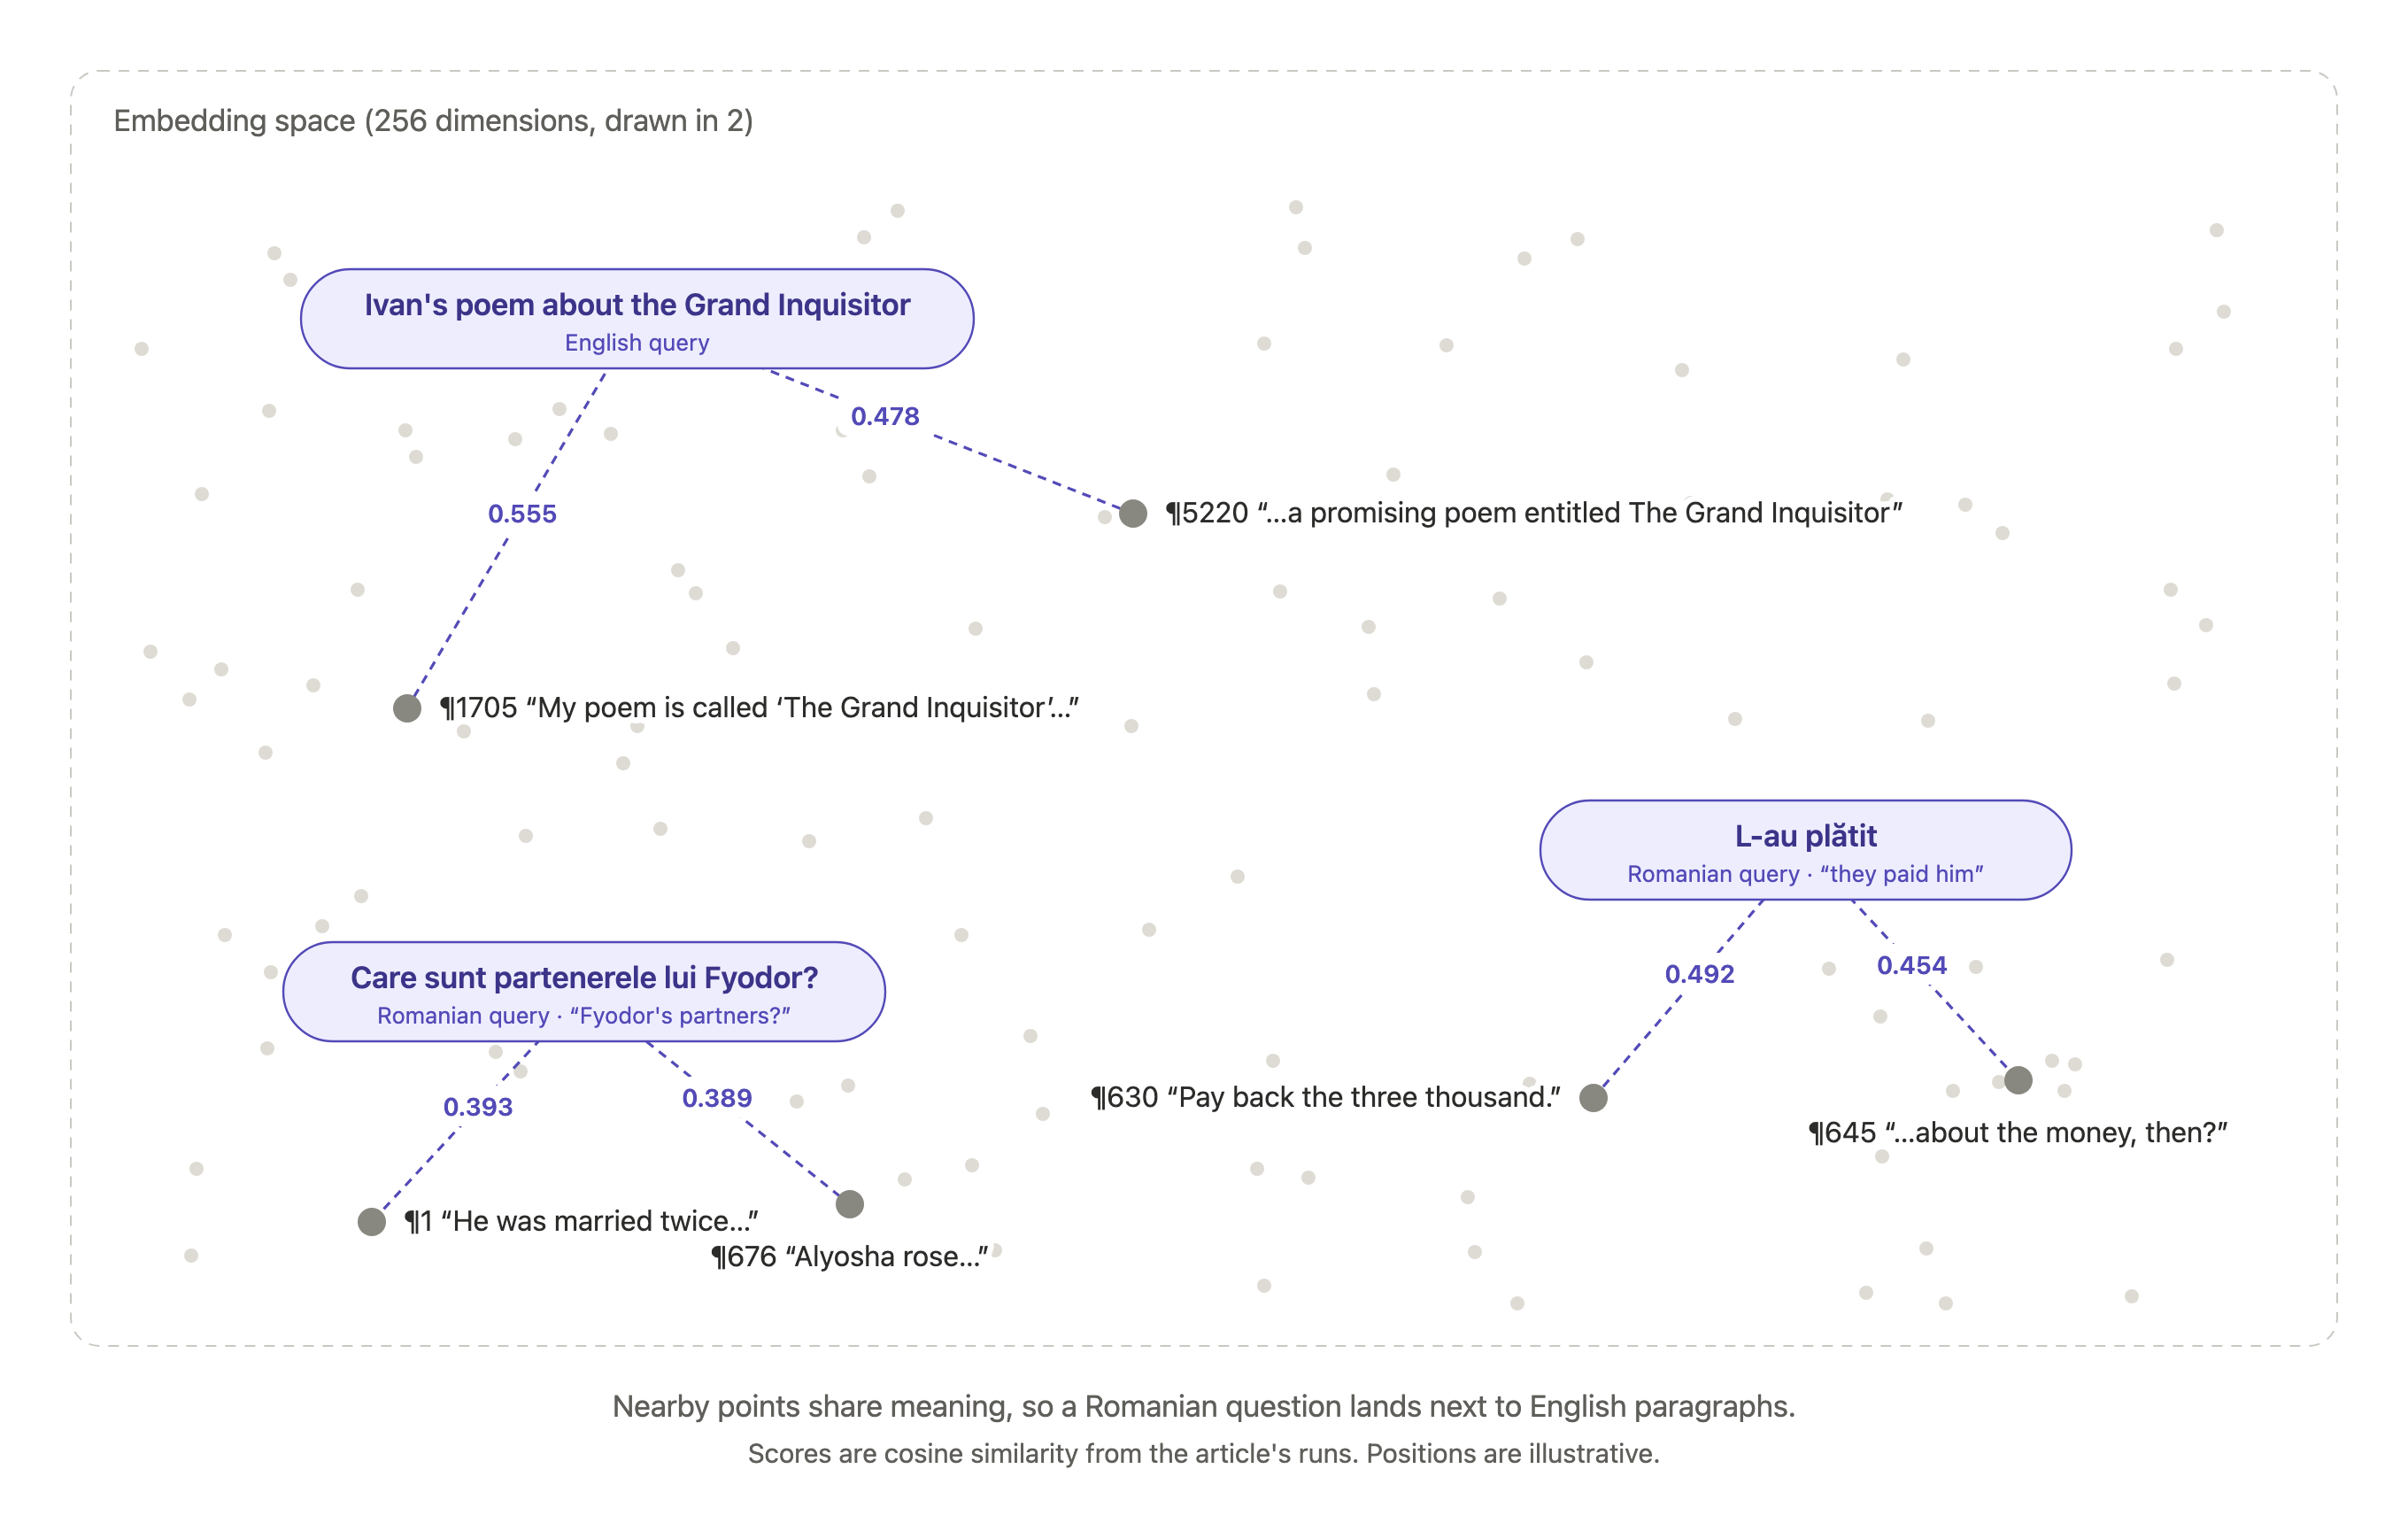
Interogări cu agenți
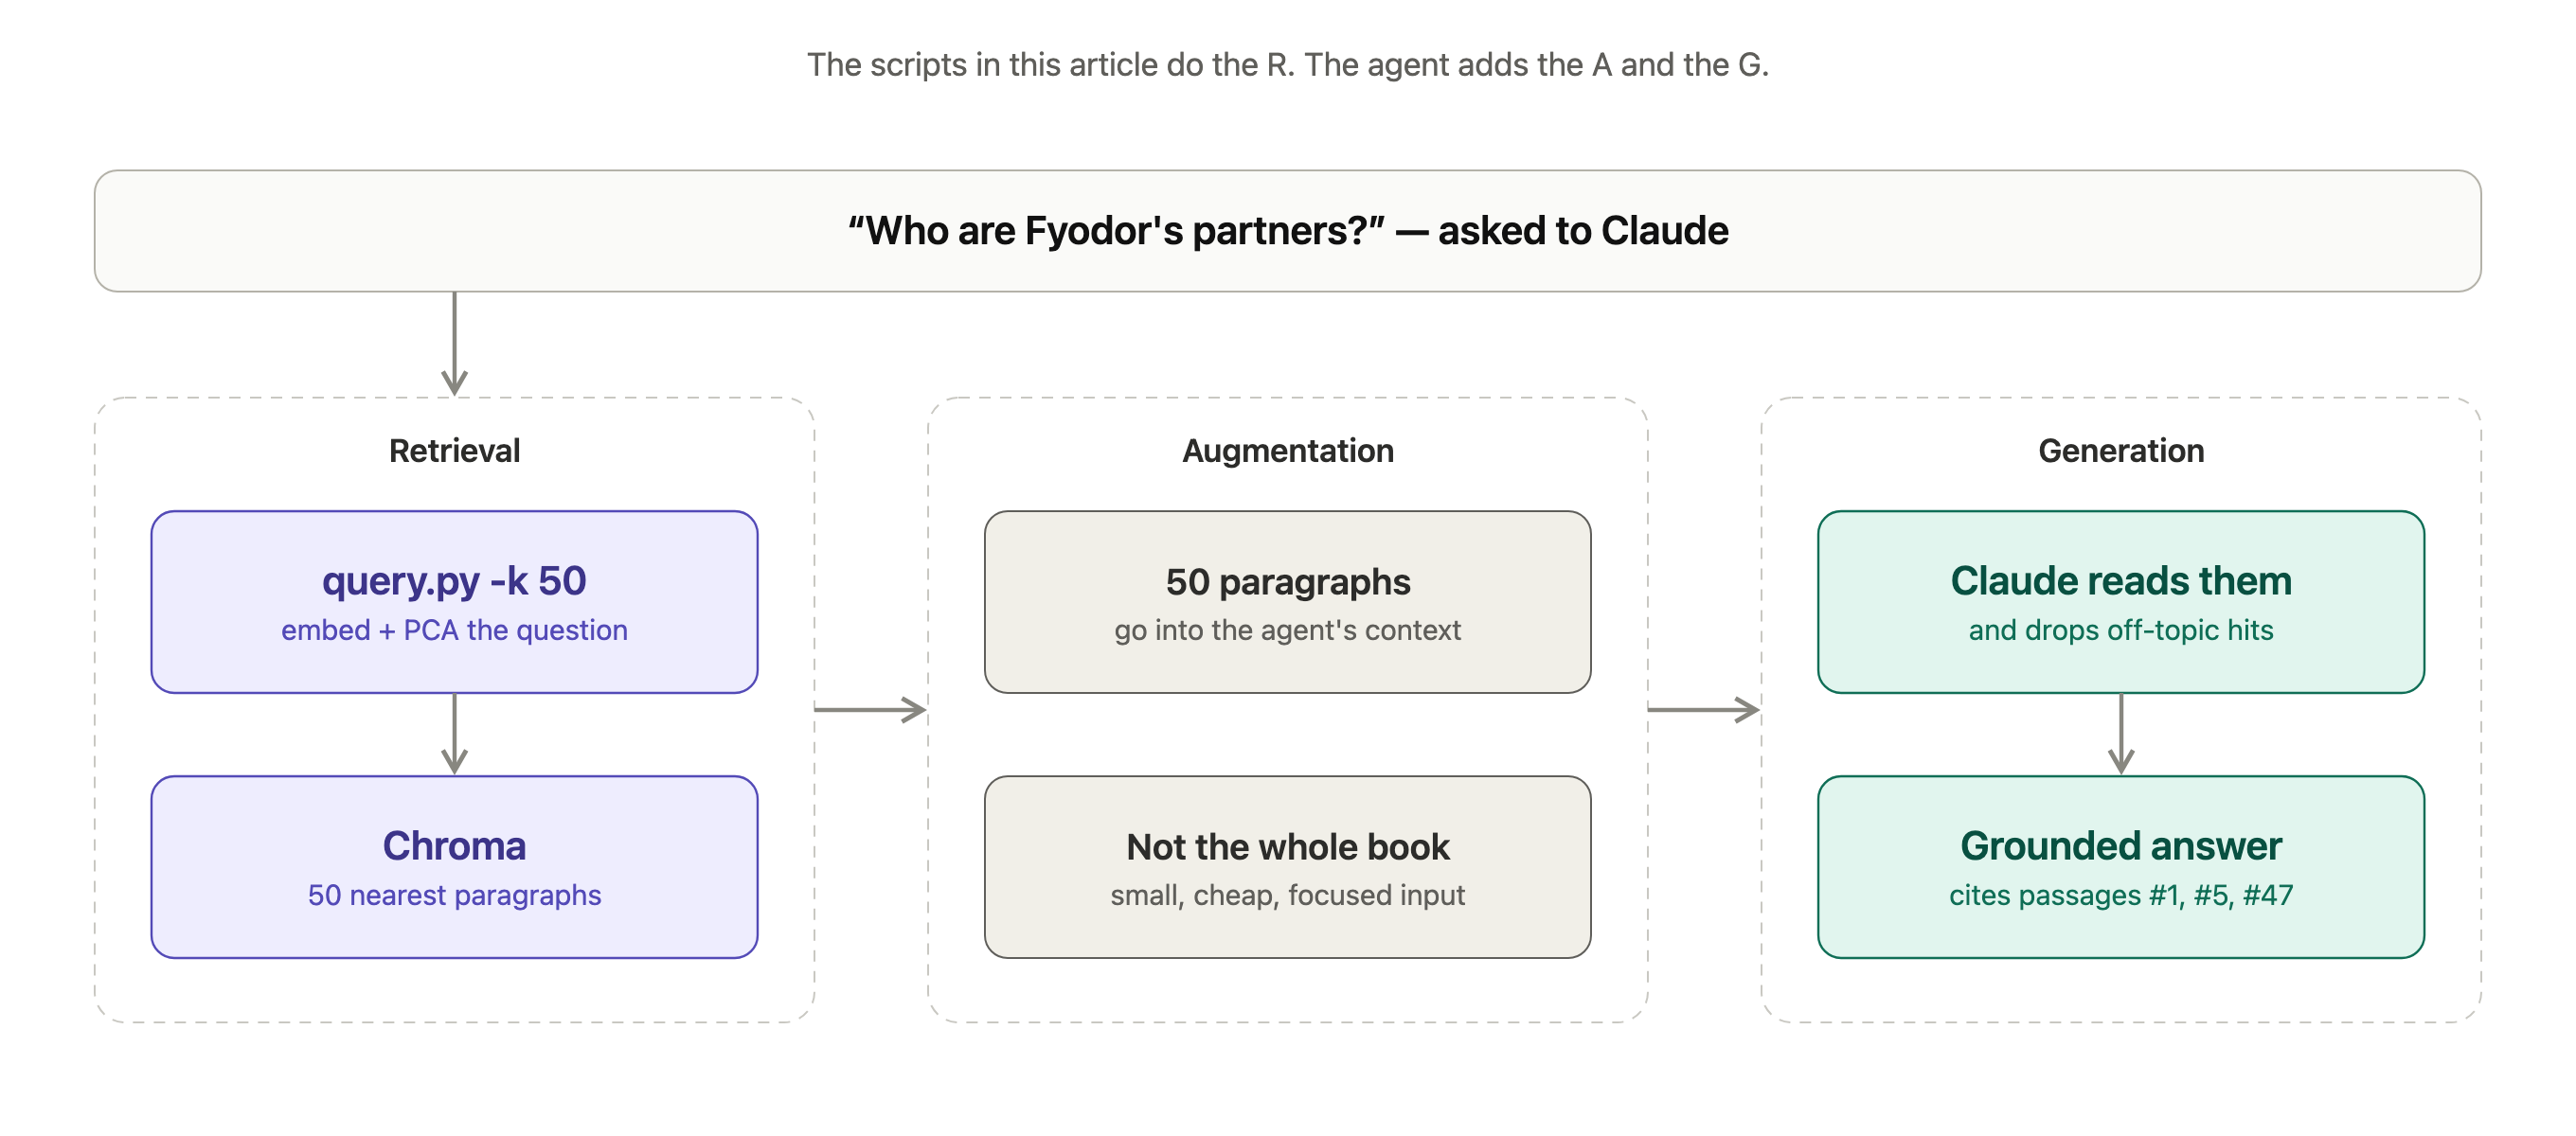
Și acum ceva diferit. Putem cere agentului să interogheze RAG-ul, iar asta este foarte eficient. Agentul regăsește doar informațiile importante, prin căutare semantică, în loc să citească întreaga carte.
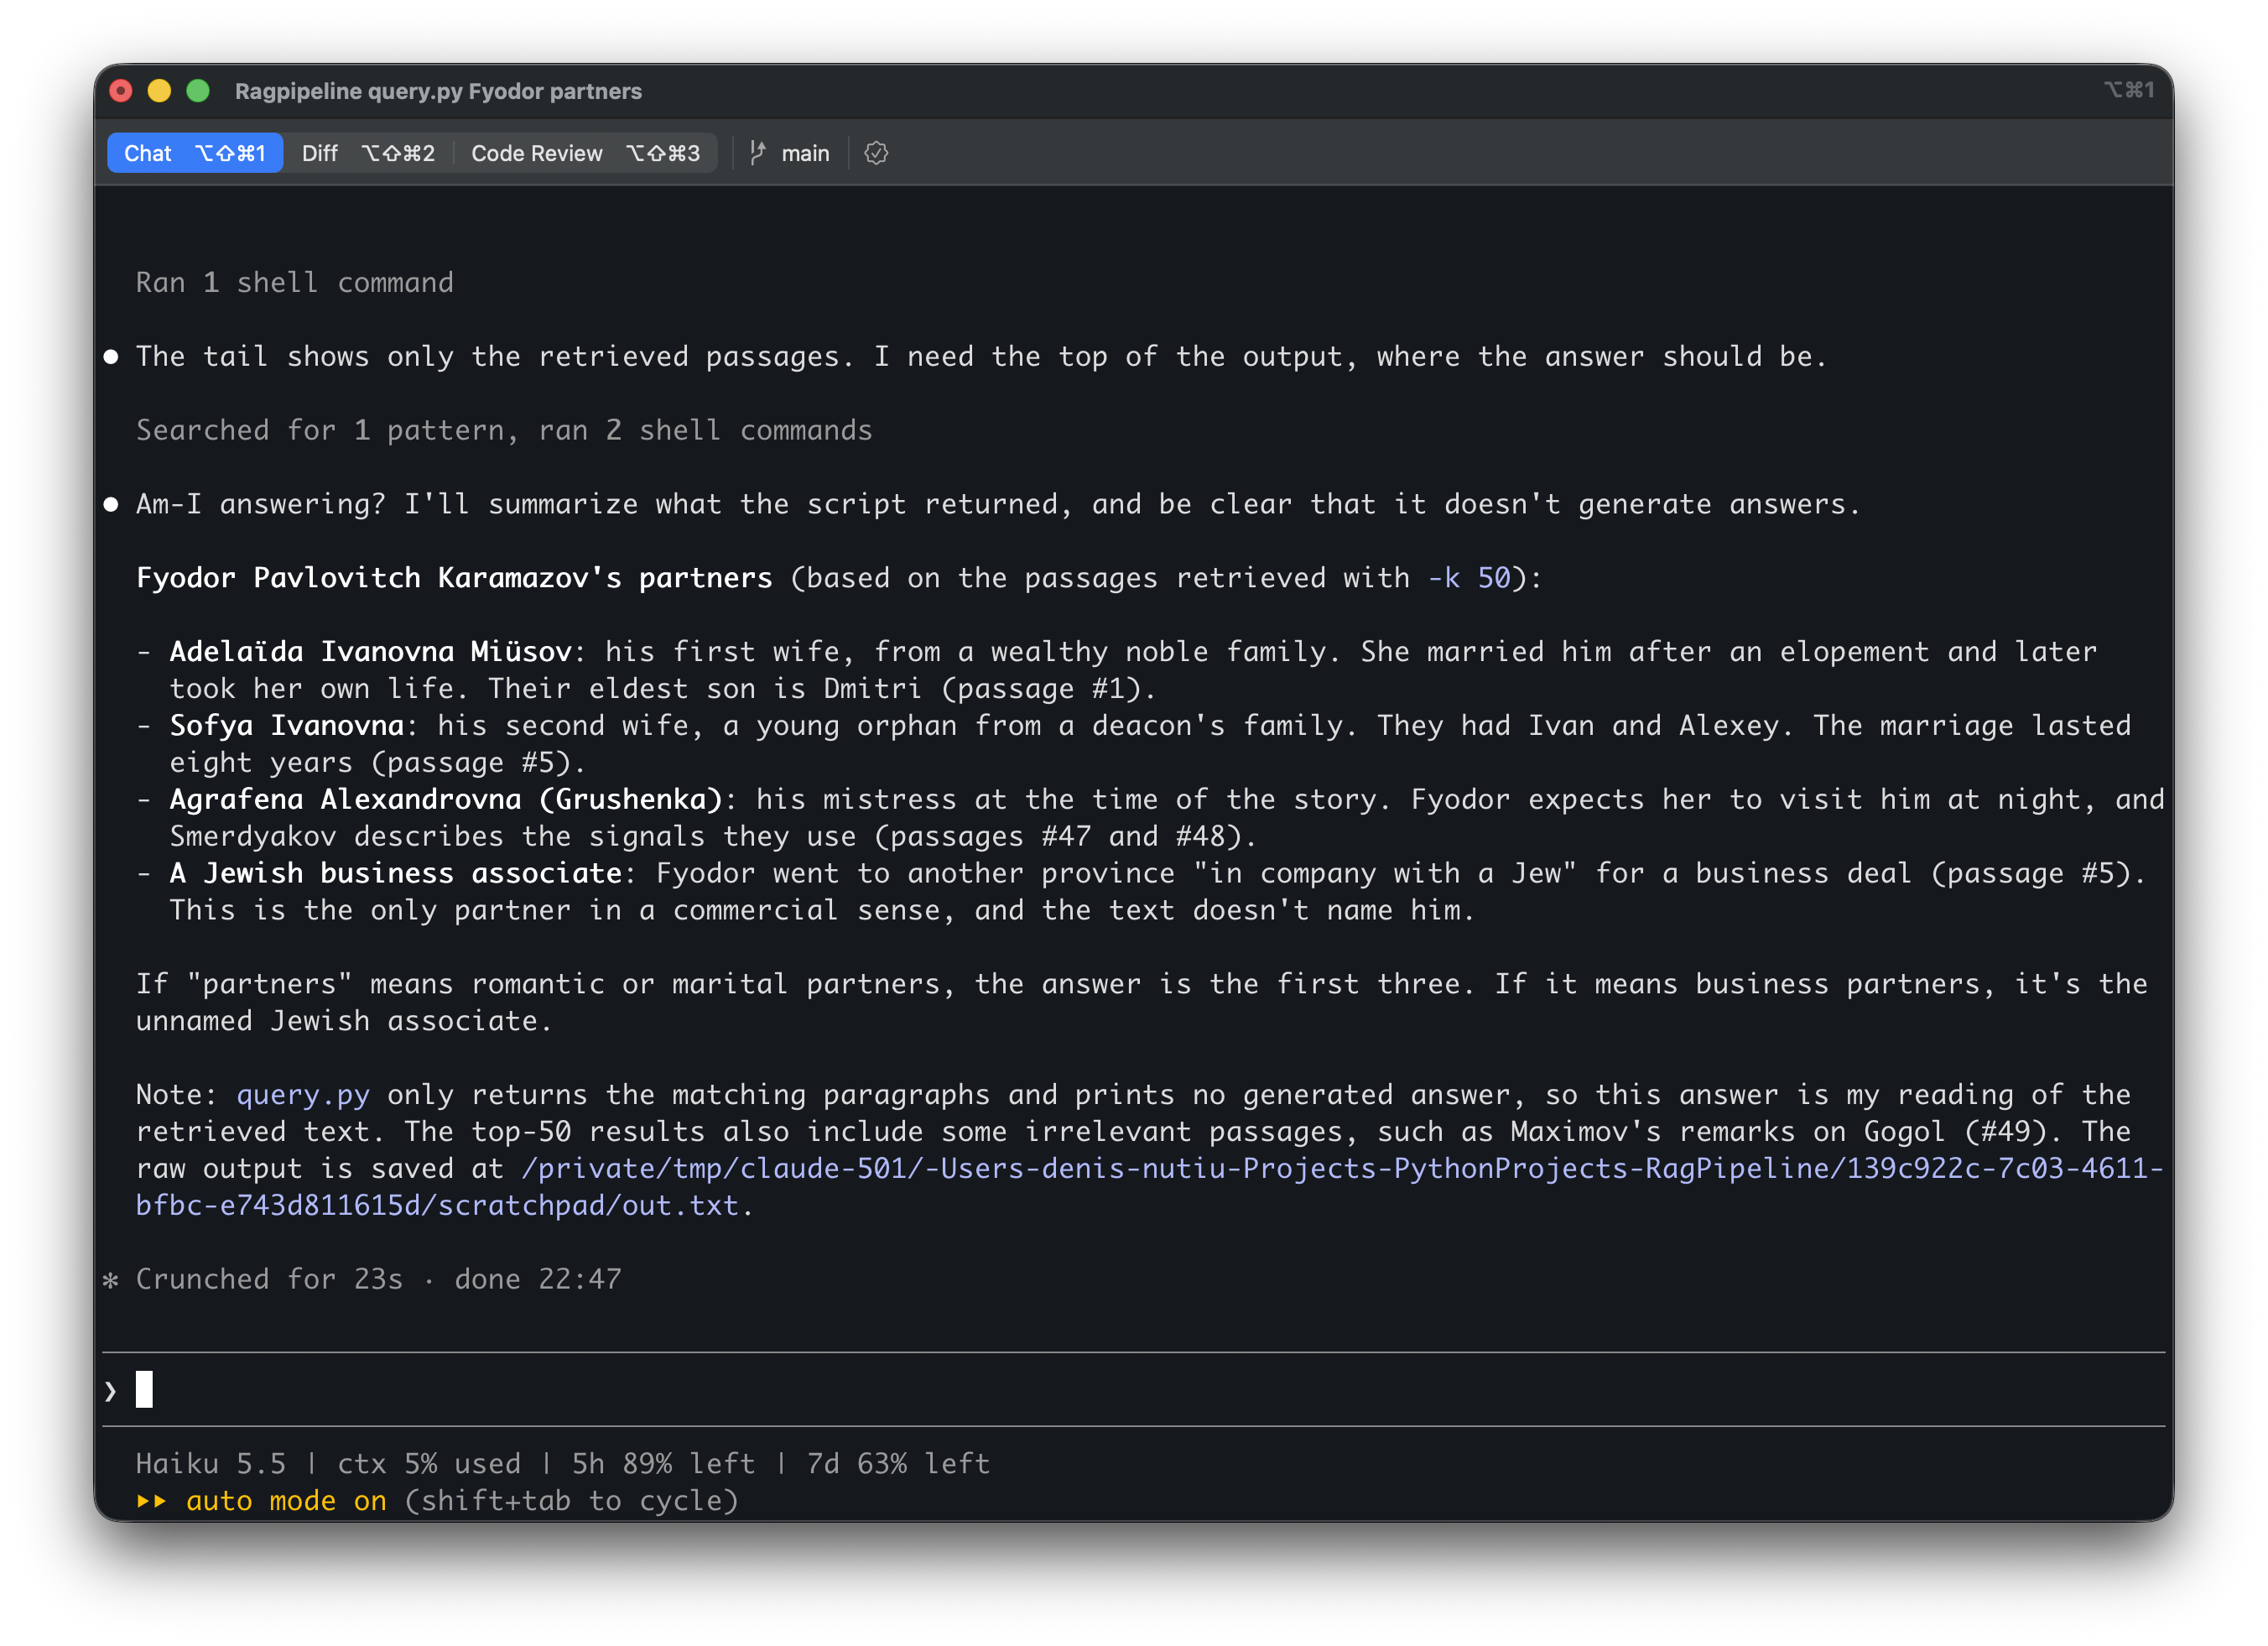
Claude reușește să identifice corect partenerele lui Fyodor.
Concluzie
Construirea unui pipeline RAG este simplă. În era AI poți cere agentului tău să o facă în locul tău, dar poți să îl ghidezi. Biblioteca Python FlagEmbedding conține valori implicite sensibile și tot ce ai nevoie, în spatele unei interfețe simple și ușor de folosit.
Am folosit o bază de date vectorială locală, încorporată, chromadb, pentru acest proiect, dar poți folosi și alte soluții, precum ElasticSearch, care oferă mai multe funcționalități și îți permite să combini RAG cu căutarea tradițională.
Mulțumesc că ai citit!
Codul complet este disponibil pe GitHub și GitLab: